Long-Horizon-Terminal-Bench: Testing the Limits of Agents on Long-Horizon Terminal Tasks with Dense Reward-Based Grading
Meta info.
- Authors: Zongxia Li, Zhongzhi Li, Yucheng Shi, Ruhan Wang, Junyao Yang, Zhichao Liu, Xiyang Wu, Anhao Li, Yue Yu, Ninghao Liu, Lichao Sun, Haotao Mi, Leowei Liang
- Affiliation: Tencent HY LLM Frontier; UMD; UGA; UMN; Indiana University; Lehigh; NUS; PolyU
- Paper: https://arxiv.org/abs/2607.08964
- Code: https://github.com/zli12321/LHTB
- Published: July 9, 2026 (arXiv preprint)
TL; DR
46개 long-horizon task를 subtask 단위 dense reward로 채점하는 LHTB 제안
17개 frontier 모델 중 최고인 Grok 4.5도 R≥0.95 기준 30% 미만으로 매우 낮은 성능
실패의 대부분은 local 오류가 아니라 time budget 소진과 조기 종료(false finish)에서 비롯됨
- 왜: 기존 terminal/SWE benchmark는 상대적으로 짧은 task와 final pass/fail에 집중, 실질 긴 workflow에서 agent가 어디까지 해냈고 어디서 fail했는지를 거의 보여주지 못함
- 제안: 46개 containerized long-horizon task + semantically meaningful subtask별 deterministic grader를 결합한 벤치마크 제안
- findings: 17개 frontier 모델에서 1개의 containerized task에서 평균 239개 에피소드, 약 9.8M 토큰 사용하여 88.9분 소요. $R\ge0.95$ 기준 평균 pass rate는 6.4%로 매우 낮은 수준, unsolved run의 79%가 time out.
- step 1개 맞추는 것보다 long 실행을 끝까지 잘 관리하는가의 문제에 가깝다.
Background
- long-horizon workflow: 수백 step, 수십 분에서 수 시간, 계속 바뀌는 long-context state 관리 필요 (Wang et al., 2026)
- 한 번의 action이 아니라 긴 결정 sequence에 걸친 지속적 진전이 결과를 결정 (Liu et al., 2026, KLong)
- e.g. 논문 결과 재현, GitHub repo 환경 설치, multimodal dataset audit, compiler toolchain 디버깅, ML training pipeline
- agent 벤치마크 현황
- terminal / software engineering: 대부분 수 분에서 최대 1시간, final state의 test 통과 여부만 채점
- SWE-Bench (Jimenez et al., 2024)
- LiveCodeBench (Jain et al., 2024), SWT-Bench (Mündler et al., 2024)
- Terminal-Bench (Merrill et al., 2026)
- 더 길고 어려운 방향: FrontierSWE (Chu et al., 2026), SWE-EVO (Le et al., 2025), SWE-Marathon (Desai et al., 2026)
- long-horizon autonomy 측정: benchmark 점수 대신 안정적으로 끝낼 수 있는 task 길이를 capability 변수로 봄
- METR time-horizon (Kwa et al., 2025)
- RE-Bench (Wijk et al., 2024), HCAST (Rein et al., 2025): 사람 기준 소요 시간으로 calibration
- short-horizon 능력이 좋아도 실행 오류 누적으로 long-horizon 성능 저하 (Sinha et al., 2025)
- outcome-only를 넘는 채점: 대부분 training reward나 judge supervision 용도, learned verifier나 LLM evaluator 의존
- process reward model (Lightman et al., 2023; Khalifa et al., 2025)
- rubric 기반 평가 (Rao & Callison-Burch, 2026; Pan et al., 2026; Tian et al., 2026)
- agent harness: 같은 모델도 harness에 따라 결과가 달라짐
- Harness-Bench (Yao et al., 2026), harness updating (Lin et al., 2026)
- SWE-agent (Yang et al., 2024), OpenHands (Wang et al., 2024), Terminus 계열, Codex
- terminal / software engineering: 대부분 수 분에서 최대 1시간, final state의 test 통과 여부만 채점
- METR 계열의 time horizon 연구도 agent가 어느 정도 길이까지의 human task를 안정적으로 완료하는가 capability variable로 확인
Problem States
- 기존 terminal 벤치마크의 두 공백
- horizon 부족: 짧은 task는 long-horizon 탐색, 오류 step 수정, 다단계 디버깅의 난도를 과소평가
- 9할까지 왔는데 못푼건지, 아예 시도부터 틀렸는지 구분하지 않음 → 실제 개선으로 이어지기 어려움
- outcome-only sparse grading: 거의 다 해낸 agent와 처음부터 실패한 agent가 같은 0점
- final test 단일로 성공/실패를 판정하면, 갖은 원인이 뭉개짐
- partial progress
- near miss
- timeout
- premature stopping
- weak self-verification
- final test 단일로 성공/실패를 판정하면, 갖은 원인이 뭉개짐
- horizon 부족: 짧은 task는 long-horizon 탐색, 오류 step 수정, 다단계 디버깅의 난도를 과소평가
- 필요 조건
- 수백 episode, 수십 분 이상이 필요한 task → Task Formulation
- 끝까지 완수하지 못하더라도 어디까지 해냈는지 드러내는 scoring이되 LAAJ 없이 deterministic → Subtask-based Grading
- public test만 patch하거나 출력을 hard-coding해서 점수를 얻지 못하게 하는 구성 → Dataset Construction
Suggestions
definition
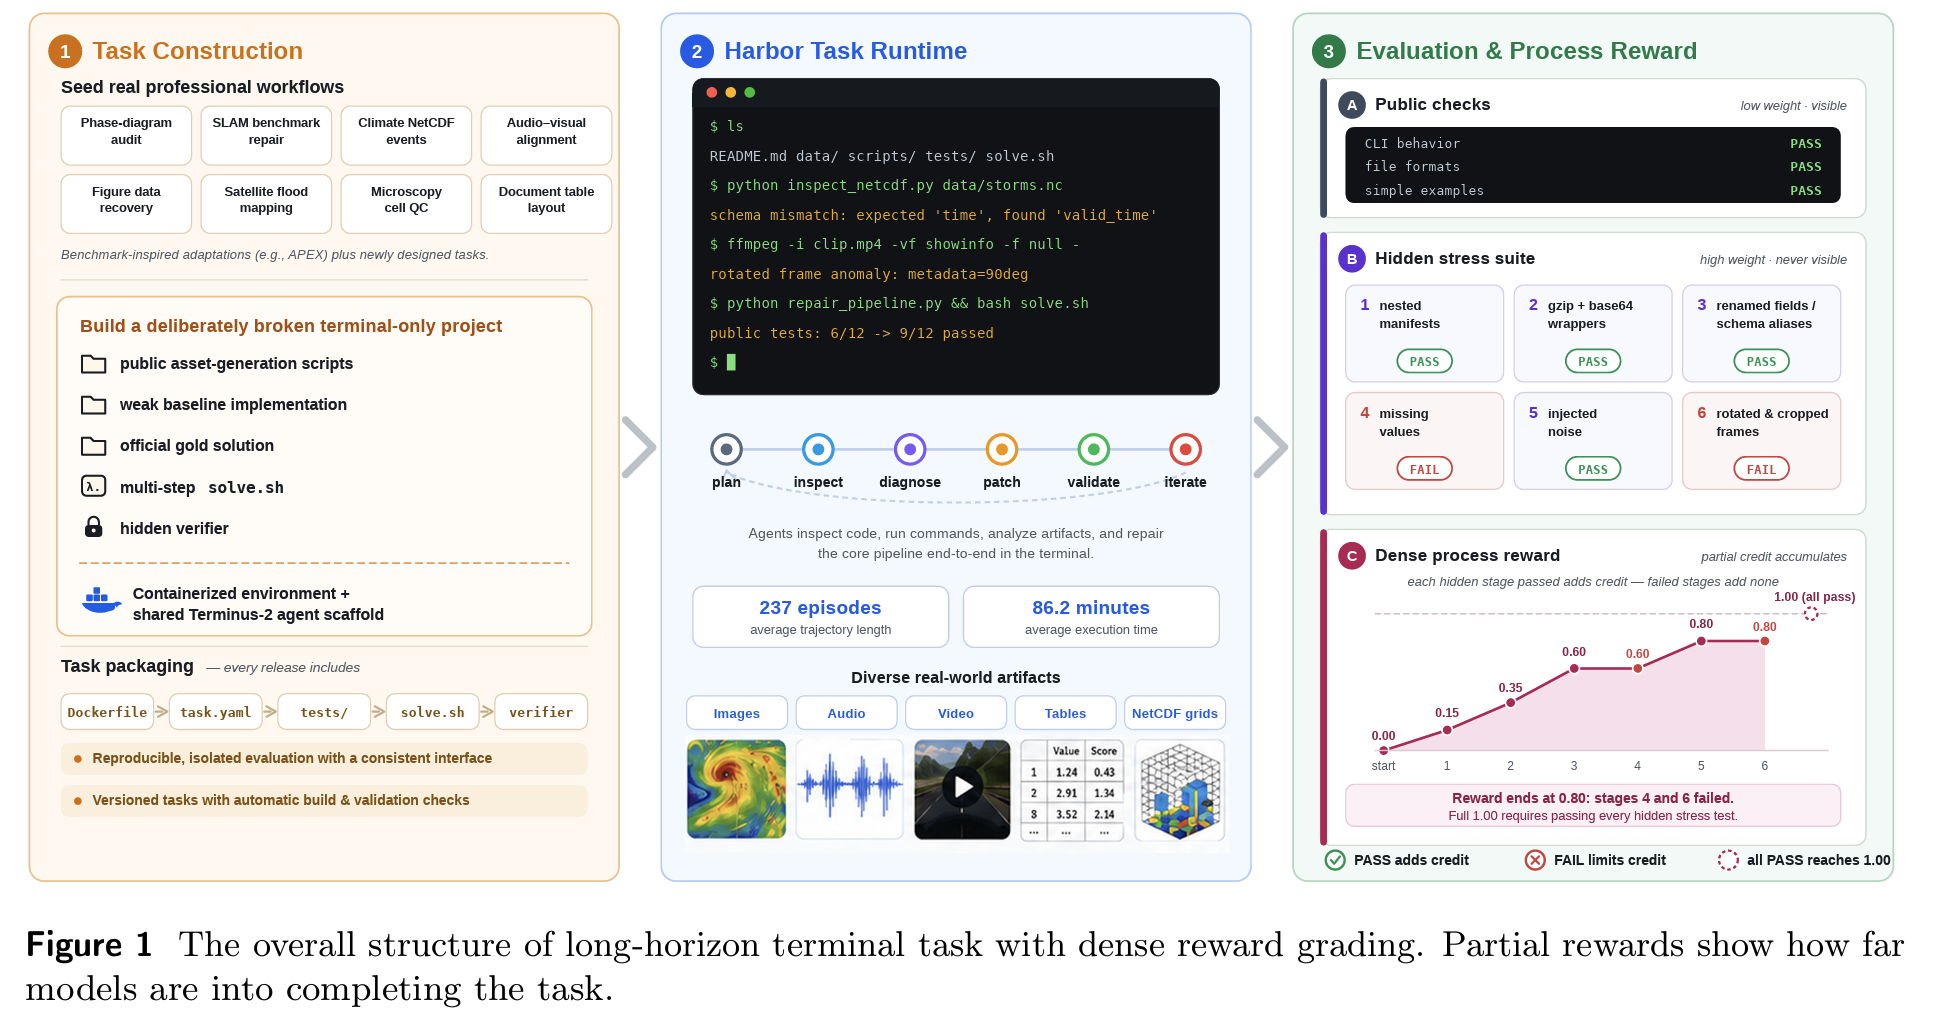
- task 하나 = subtask 집합 $\lbrace s_1, \dots, s_K \rbrace$, rollout 종료 시 container 안의 deterministic grader가 각 $r_k \in [0, 1]$ 계산
- task reward는 subtask 점수의 가중 평균
- $w_k$: non-negative weight, 기본은 동일하고 필요하면 final goal에 가중
- $r_k$: final container state의 객관적 증거(파일, 출력, test 결과, simulator 응답)로만 채점
- $R \ge \tau$이면 resolved; pass@1은 전체 task 중 threshold를 넘은 비율
- 주 지표 $\tau = 0.95$ (relaxed), 보조로 $\tau = 0.9$, $\tau = 1.0$
- 다 못 푼 task의 진전은 mean normalized reward (task 평균 R)로 따로 보고
task formulation
- Terminal-Bench 형식 그대로의 Harbor task (Harbor Framework Team, 2026)
- instruction + Docker image + task configuration + oracle implementation 또는 simulator
- asset, code, data, tool, helper script가 모두 image 안에 있어 terminal만으로 완결
- agent’s input: 전체 long-horizon 목표를 적은 instruction 하나
- instruction + Docker image + task configuration + oracle implementation 또는 simulator
- interactive 진행: 수백 step 동안 command 실행, 파일 수정, 중간 출력 확인 반복, 성공 또는 timeout까지
- TB2와의 차이: 형식은 같고, subtask 하나가 이미 수 분에서 수 시간, 수십에서 수백 operation을 요구하도록 설계
- long-horizon의 출처: 도메인 자체(ML pipeline, campaign형 게임, 과학 audit) + 목표를 시간에 걸쳐 발견해야 하는 중간 target으로 분해하는 방식
subtask-based grading
- binary pass/fail 대신 subtask completion rate로 partial credit
- subtask 유형 3가지
- Binary: 환경 state에 대한 Boolean 조건 (unit test 전부 통과, 지정 port 응답, script 무오류 실행)
- Continuous / thresholded: 재현 metric이 tolerance 안이면 1.0, 오차가 커질수록 0까지 선형 감소; held-out 예시 중 oracle 일치 비율
- Episode-aggregating: 게임, 반복 audit에서 여러 episode의 success flag 비율이나 평균 normalized reward
- 한 번 운 좋게 성공이 아니라 여러 episode에 걸친 안정성 측정
- e.g.
Fig 1final artifact가 일부 hidden verification stage만 통과하면 0.80의 partial reward를 받고, 모든 stage를 통과해야 1.00에 도달limate-netcdf-extreme-event-audit- 전체 목표: 망가진 climate audit pipeline을 fix
- grader: 최종 container state에서 여러 requirement를 따로 검사
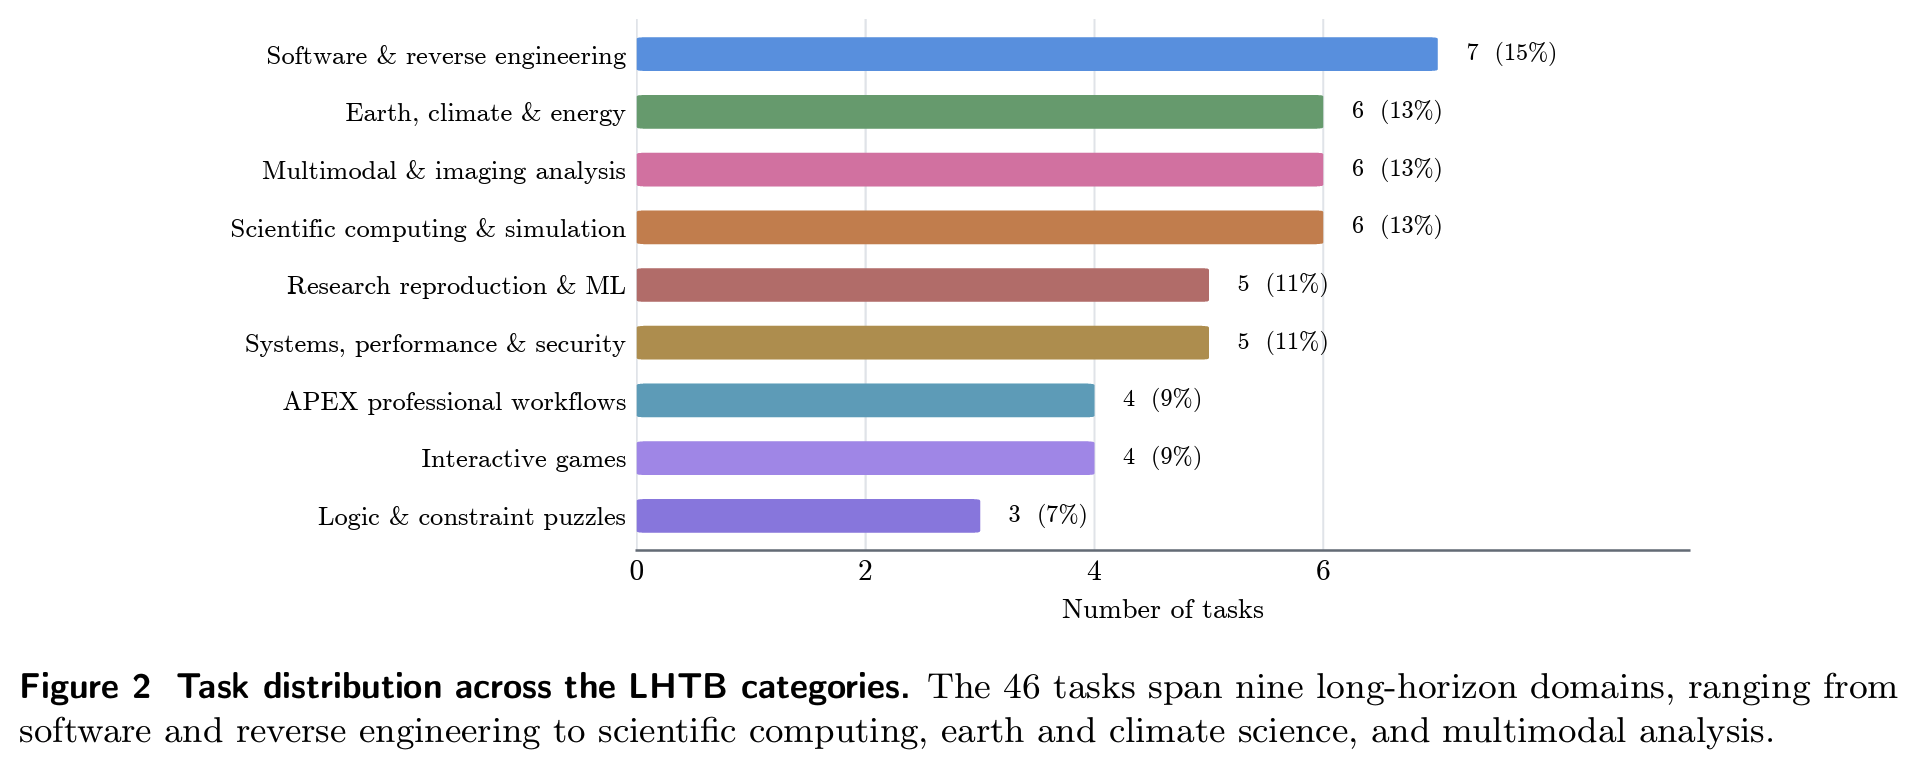
dataset construction Fig 2
- 실제 전문 workflow에 공통 recipe 적용 (Vidgen et al., 2026, APEX-Agents; Wu et al., 2026)
- seed
- phase-diagram audit
- SLAM benchmark 수리
- climate NetCDF 극한 사건 탐지
- audio-visual alignment
- figure data 복원
- 위성 홍수 탐지
- 세포 계수 QC
- 스캔 문서 table 복원
- 일부는 APEX-Agents 등에서 변형, 나머지는 신규
- seed
- 각 문제마다 완결되어 있지만 일부러 훼손된 terminal-only project 구축
- 정상적으로 작동하는 완결된 project와 정답 solution을 알고 있는 상태를 구축하고, 일부를 훼손하여 agent에게 주는 형태
- 패키지: public asset 생성 script, weak baseline, official gold solution, multi-step
solve.sh, hidden verifier
- public check vs hidden stress suite 가중치 분리
- public: CLI 동작, 파일 형식, 단순 예시 몇 개만, 낮은 가중치
- hidden: 더 어려운 입력과 schema 변형을 동적 생성, reward 대부분 차지
- nested manifest
- gzip+base64 wrapper
- 이름 바뀐 field
- 결측값, noise, 회전/crop 이미지, 이상 frame, 다른 좌표계나 time-dimension 규약
- hard-coding이나 public patch로는 고득점 불가 (gold solution은 hidden suite 전체에서 1.0 필수)
- DeepSeek-V4-Pro를 1.5시간 budget으로 반복 실행하며 초기 120개 task에 대해 difficulty calibration을 거쳐 최종 46개로 선별
Effects
- Experimental setup
- environment: LHTB 46 task, 90분 timeout
- agent: Harbor + Terminus-2 harness, 단일 terminal session
- 예외: GPT-5.3 Codex만 Codex harness
- 모델 17종: GPT-5.6-sol, GPT-5.5, GPT-5.4, GPT-5.3 Codex, DeepSeek V4 Pro, Gemini 3.1 Pro, GLM 5.1, GLM 5.2, Kimi K2.6, Kimi K2.7 Code, MiniMax M3, Qwen3.7 Max, Qwen3.6 Plus, Doubao Seed 2.1 Pro, Hy3, Grok 4.20, Grok 4.5
- evaluation: pass@1 (τ = 0.9 / 0.95 / 1.0), mean R, episode 수, 시간, 비용, token
- 비용은 2026년 6월 list price, prompt cache 할인 미반영
- 모델-task당 단일 run (17 × 46 = 782 run)
- Results
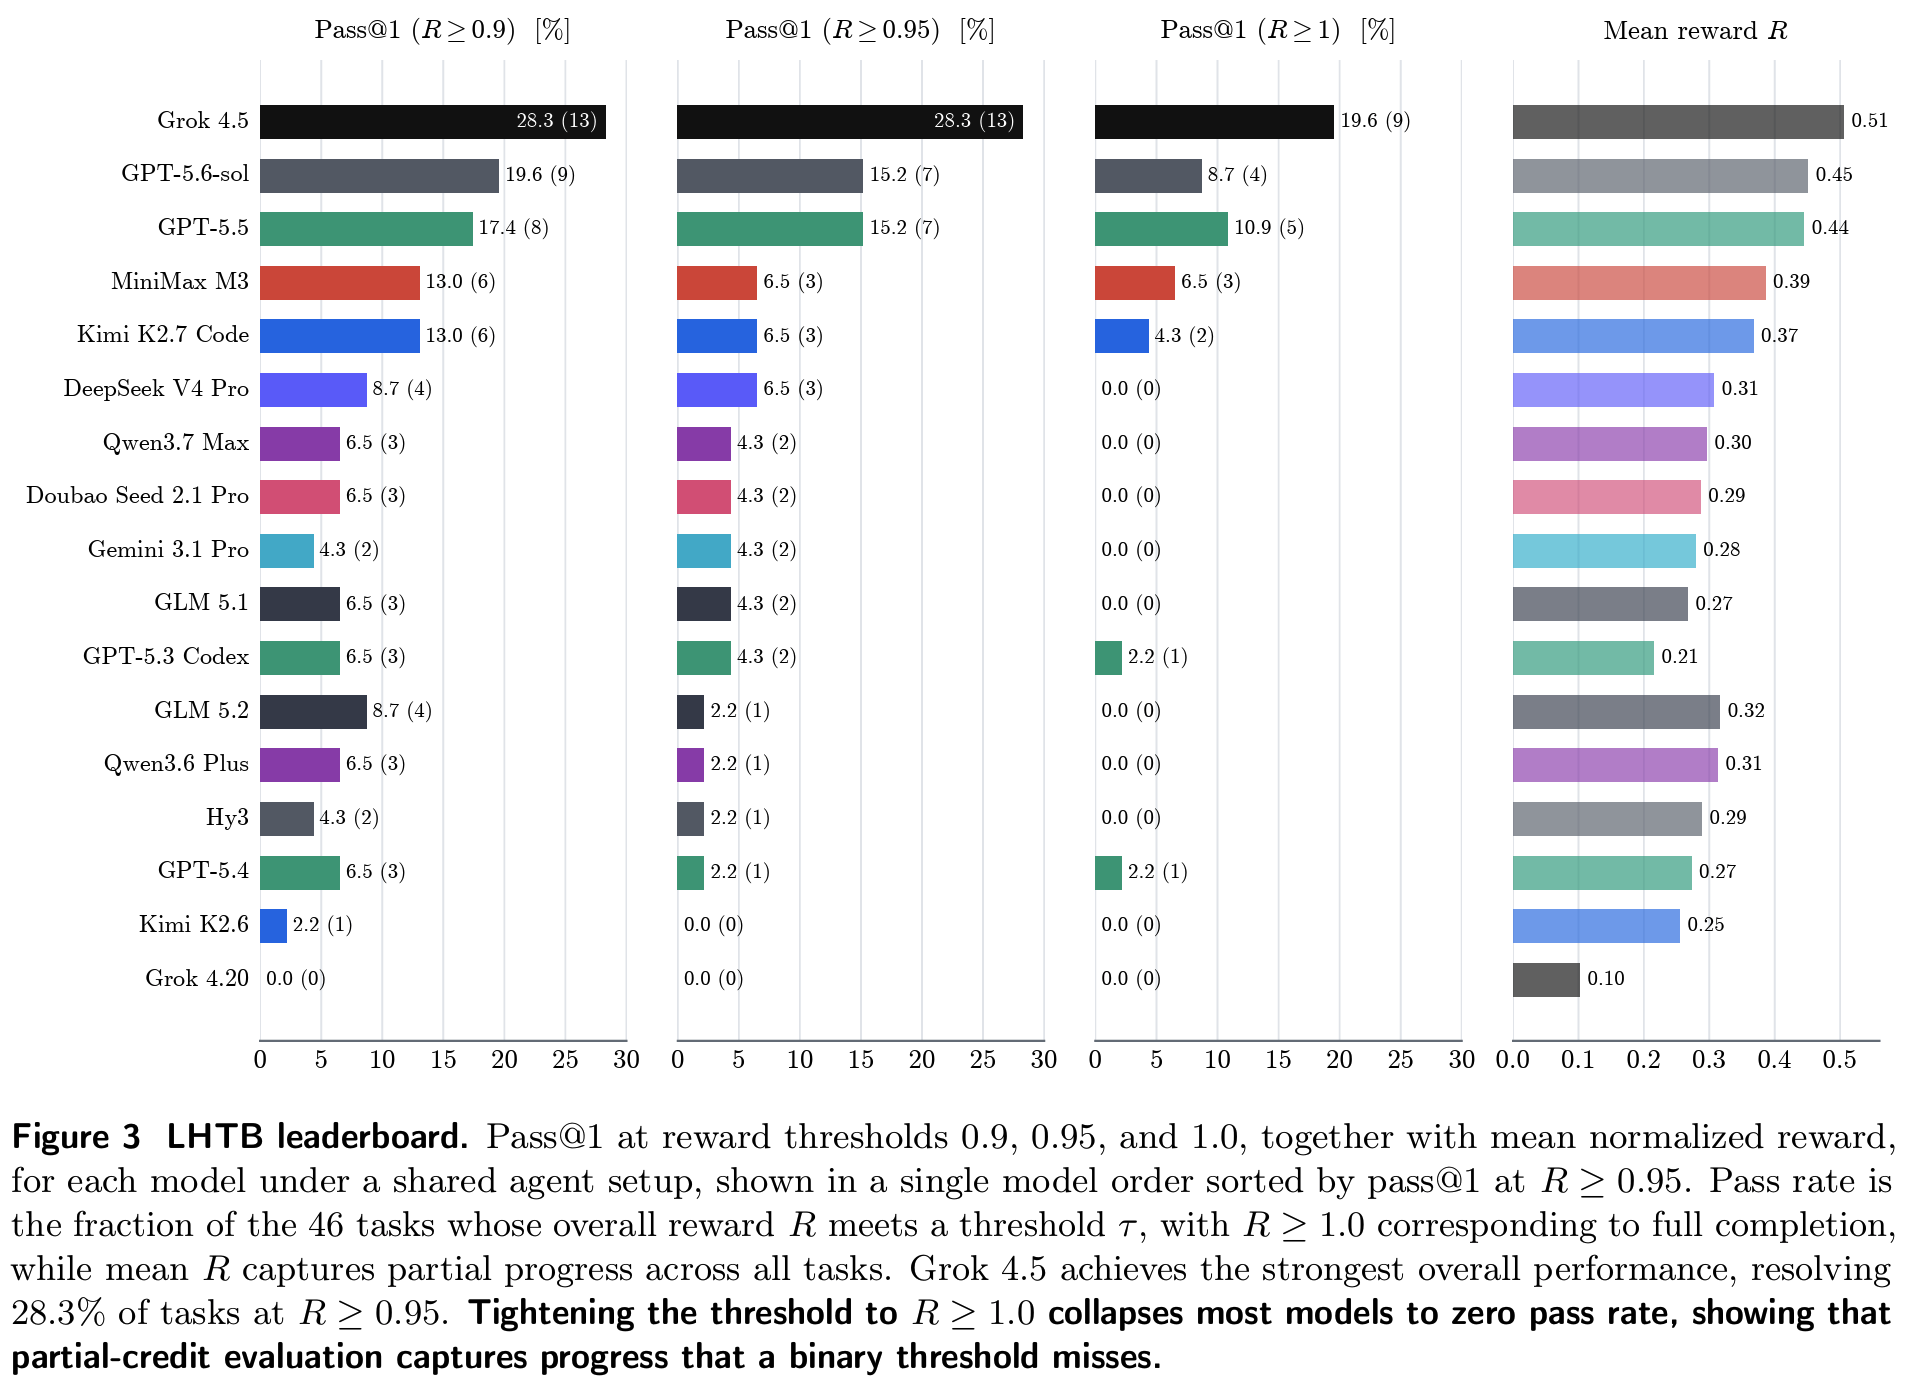
Fig 3Main: frontier 모델도 크게 고전- Grok 4.5 최고: 28.3% (13/46) @ R≥0.95
- GPT-5.6-sol, GPT-5.5가 15.2% (7/46)
- 전체 평균 pass@1은 R≥0.95에서 6.4%, R≥1.0에서 3.2%
- Finding 1
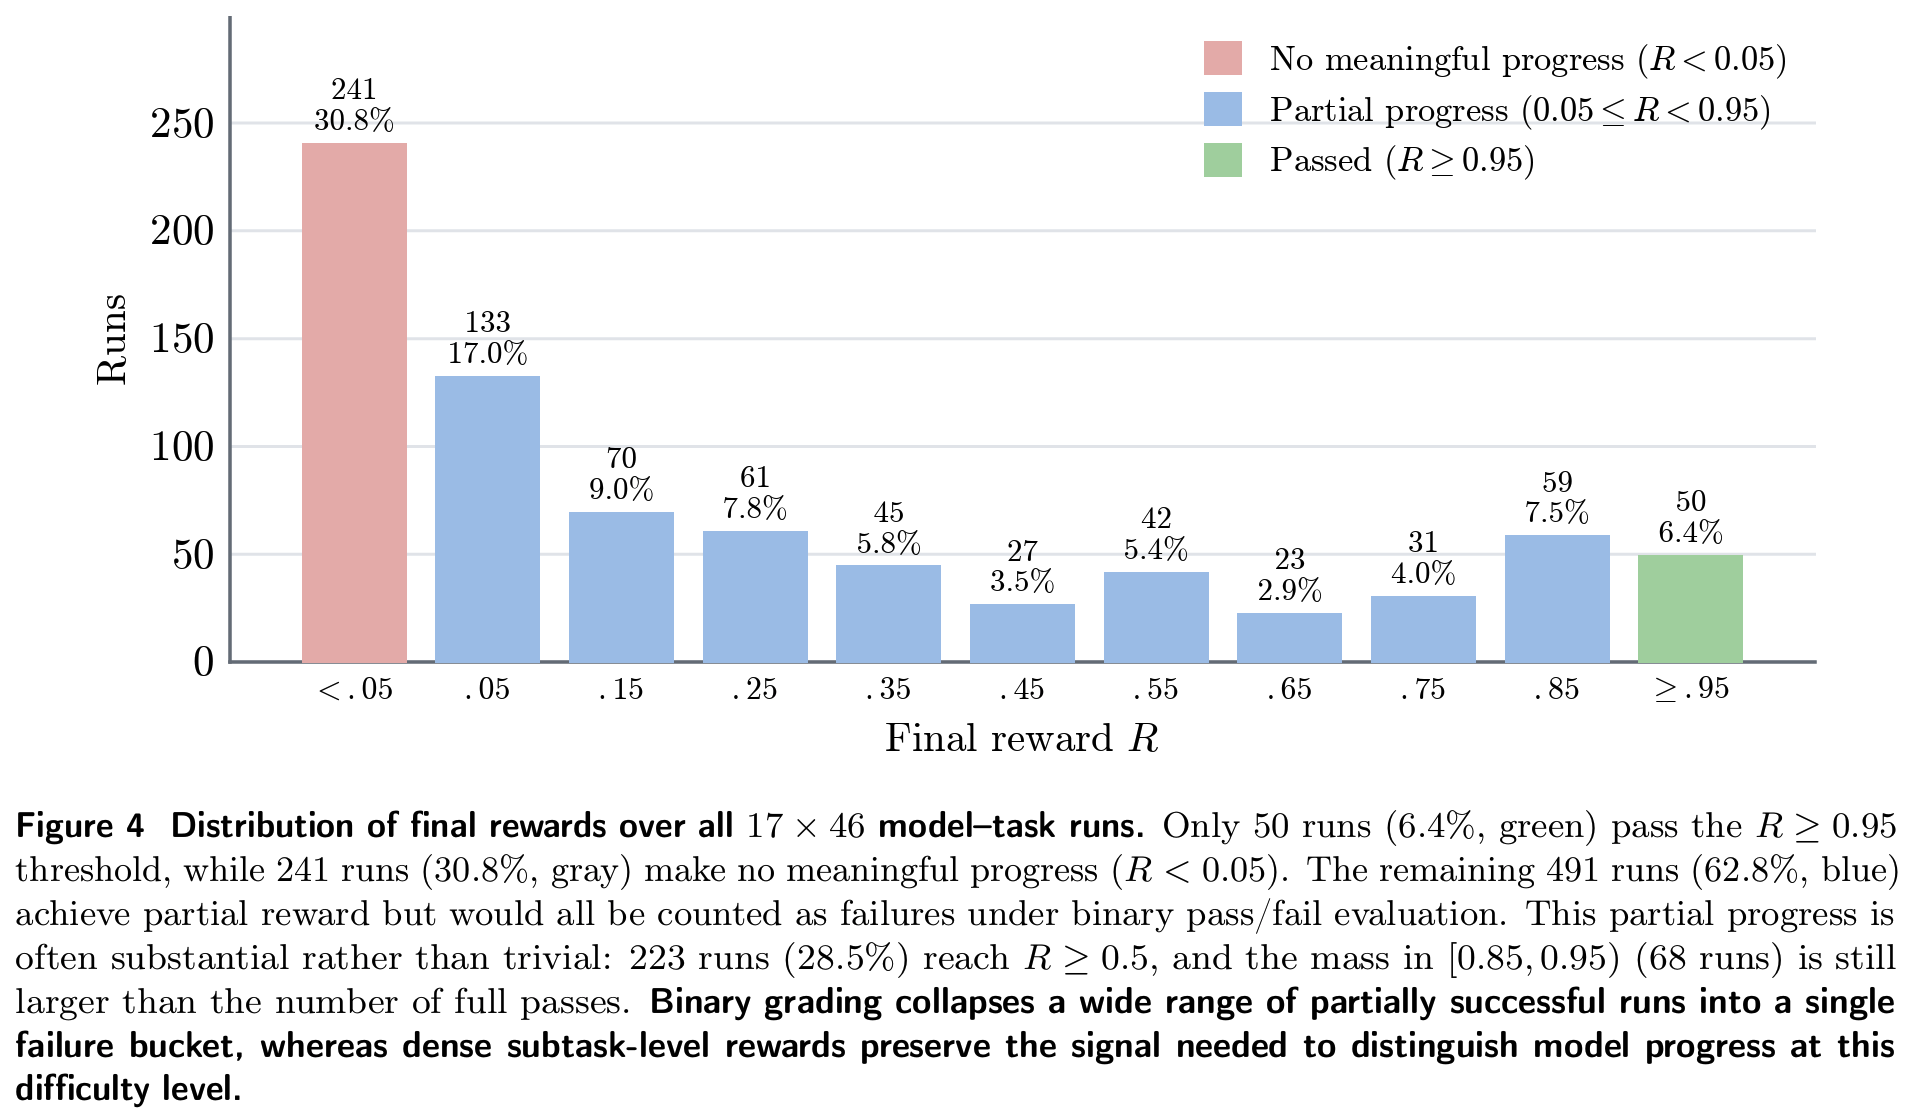
Fig 3Fig 4: dense reward가 있어야 순위가 드러남 (세밀하게 채점하자)- R≥1.0 기준으로는 17개 중 10개 모델이 0개 → binary면 큰 동점 그룹!!
- 782 run 중 pass 50 (6.4%), 진전 없음(R < 0.05) 241 (30.8%), 부분 진전 491 (62.8%)
- pass rate와 mean R은 Spearman ρ = 0.74로 중간 수준 상관 → 완전 해결과 부분 진전은 다른 능력
- 1개 해결로 동점인 모델 사이에서도 mean R은 GPT-5.4 0.27부터 GLM 5.2 0.32까지
- near-miss (0.75 ≤ R < 0.95)가 pass의 거의 두 배 (90 vs 50)
- e.g. Kimi K2.6은 해결 0개지만 near-miss 5개,
grammar-fuzz-coverage-hunt에서 R = 0.94
- e.g. Kimi K2.6은 해결 0개지만 near-miss 5개,
- Finding 2
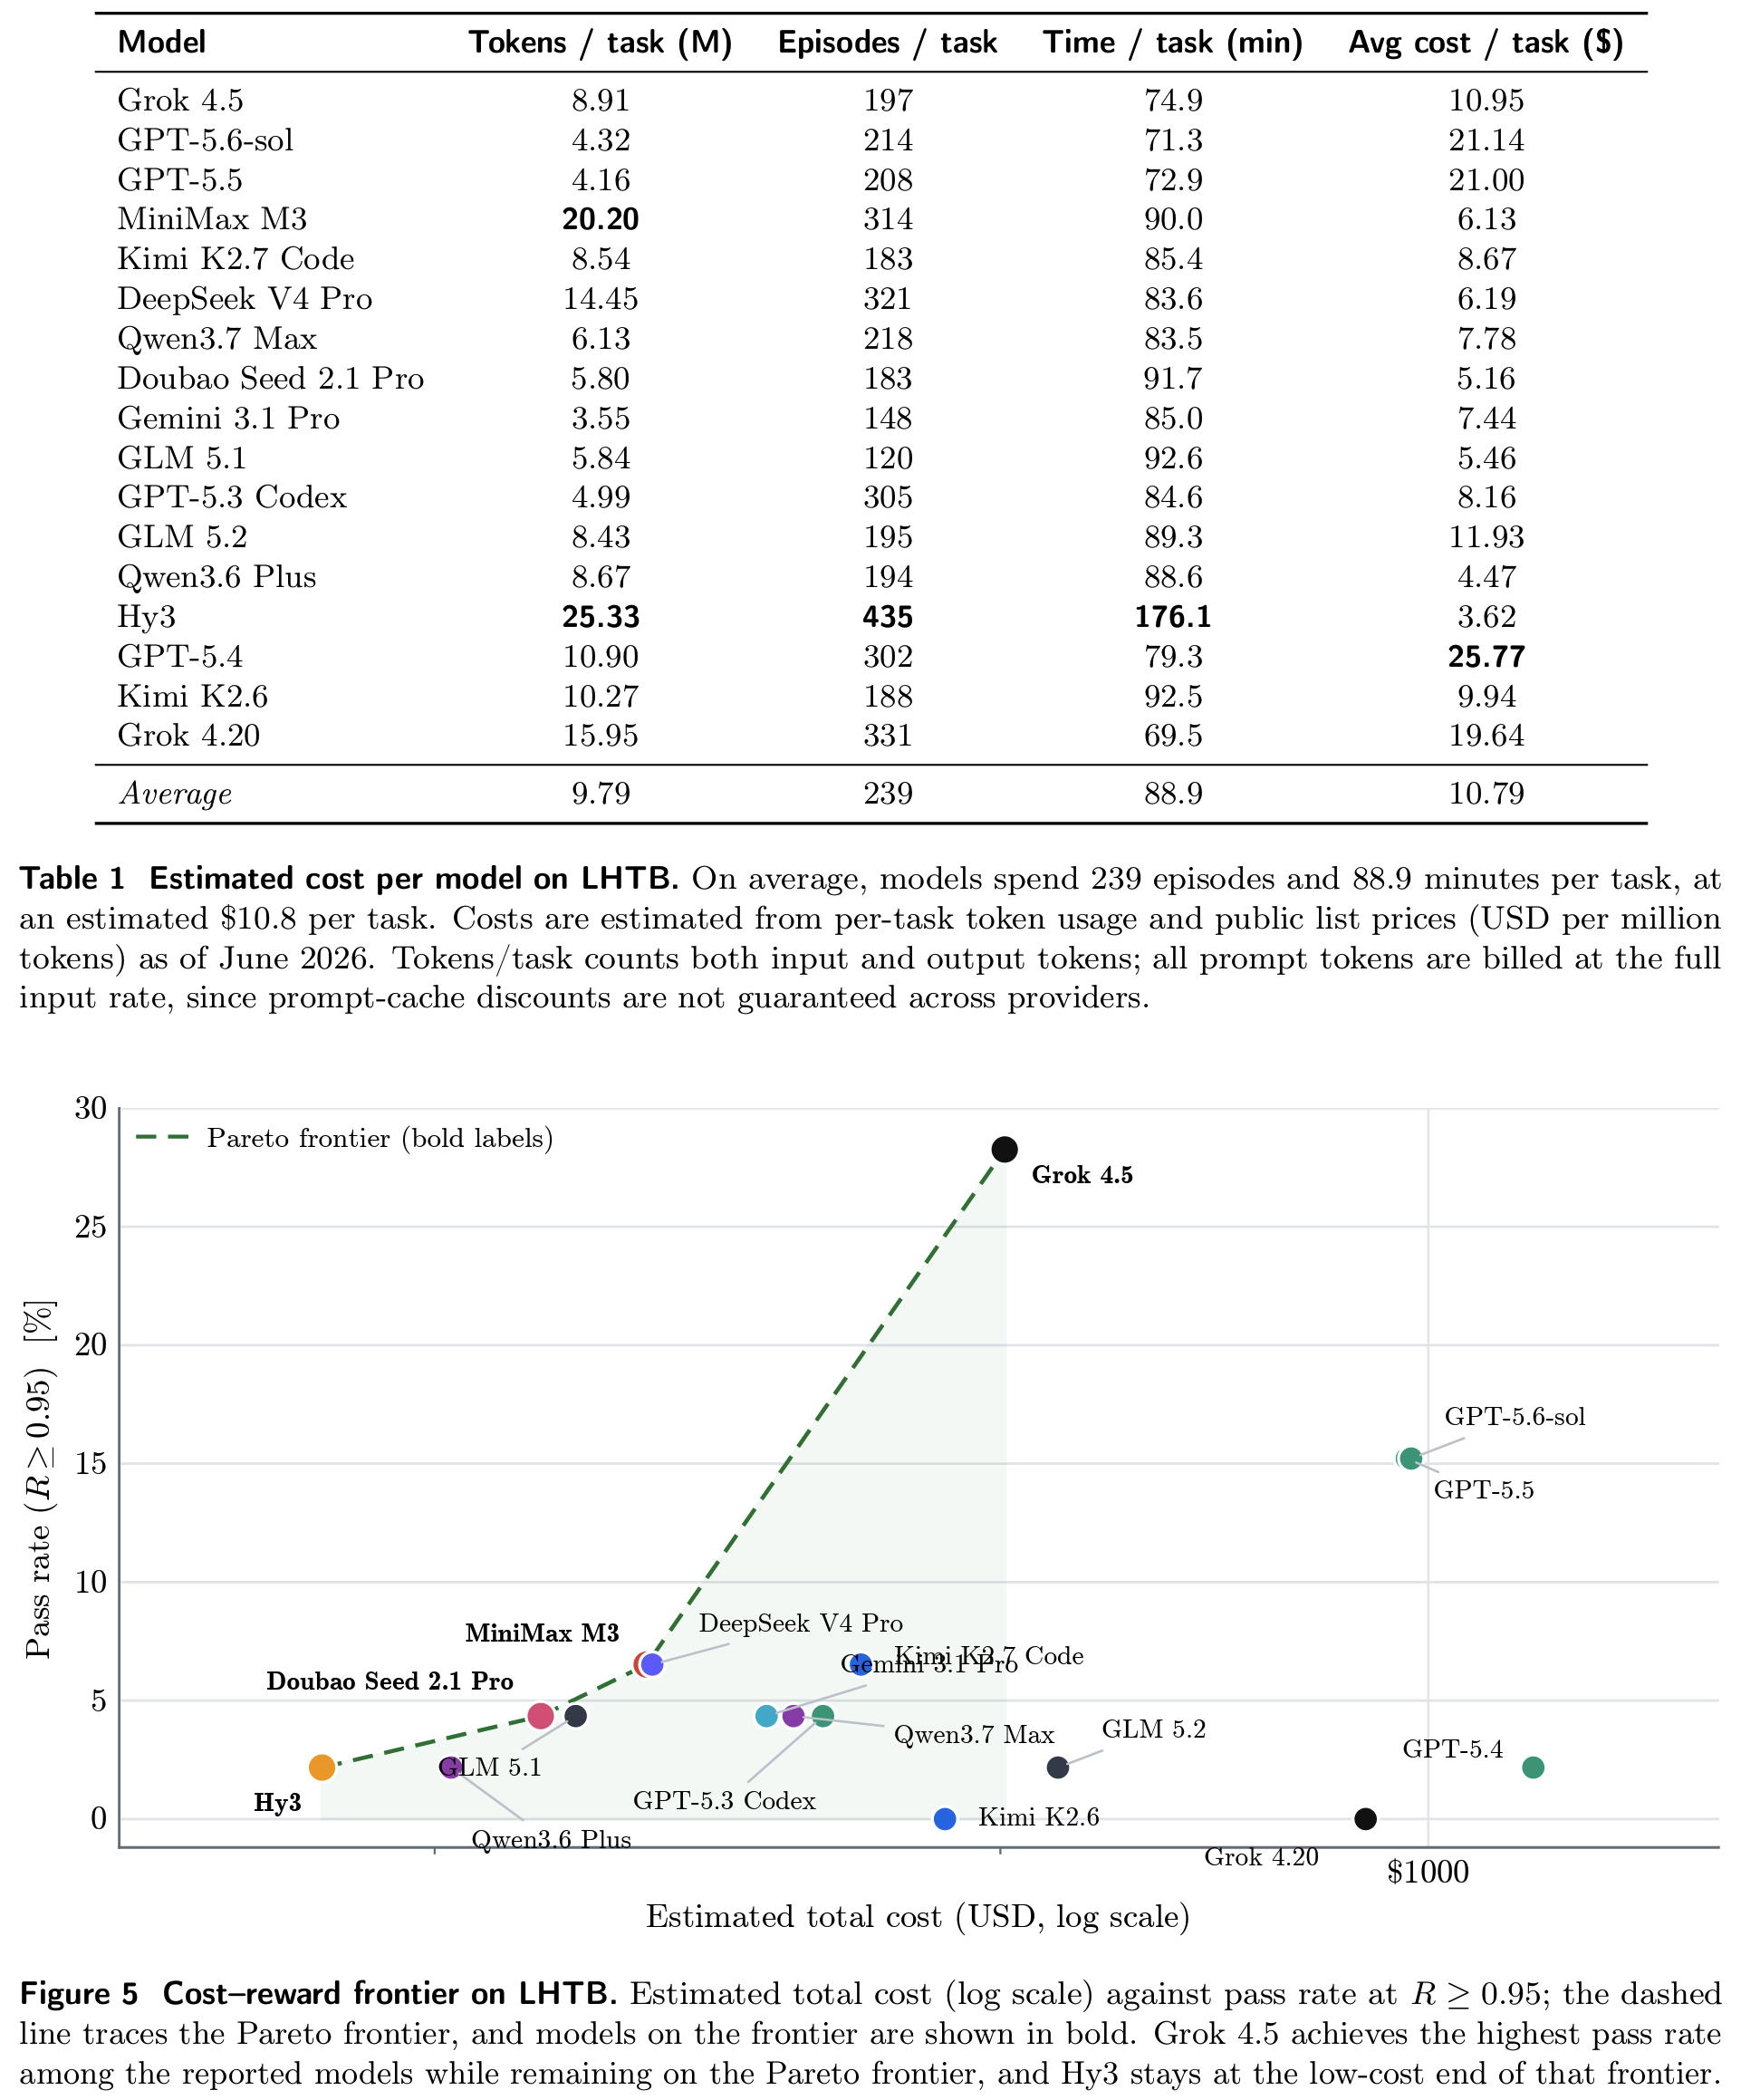
Tab 1Fig 5: 비용이 곧 성능은 아니더라- 평균 239 episode, 9.8M token, 88.9분, 약 $10.8 per task
- 모델별 약 $3.6에서 $26
- Grok 4.5는 약 $11로 Pareto frontier 상단; GPT-5.6-sol, GPT-5.5는 약 $21
- GPT-5.4는 약 $26로 최고가지만 pass rate 낮음 (episode 302 vs GPT-5.5 208)
- 저비용 frontier: Hy3 ($3.6), Doubao Seed 2.1 Pro (약 $5), MiniMax M3 (약 $6)
- 평균 239 episode, 9.8M token, 88.9분, 약 $10.8 per task
- Finding 3
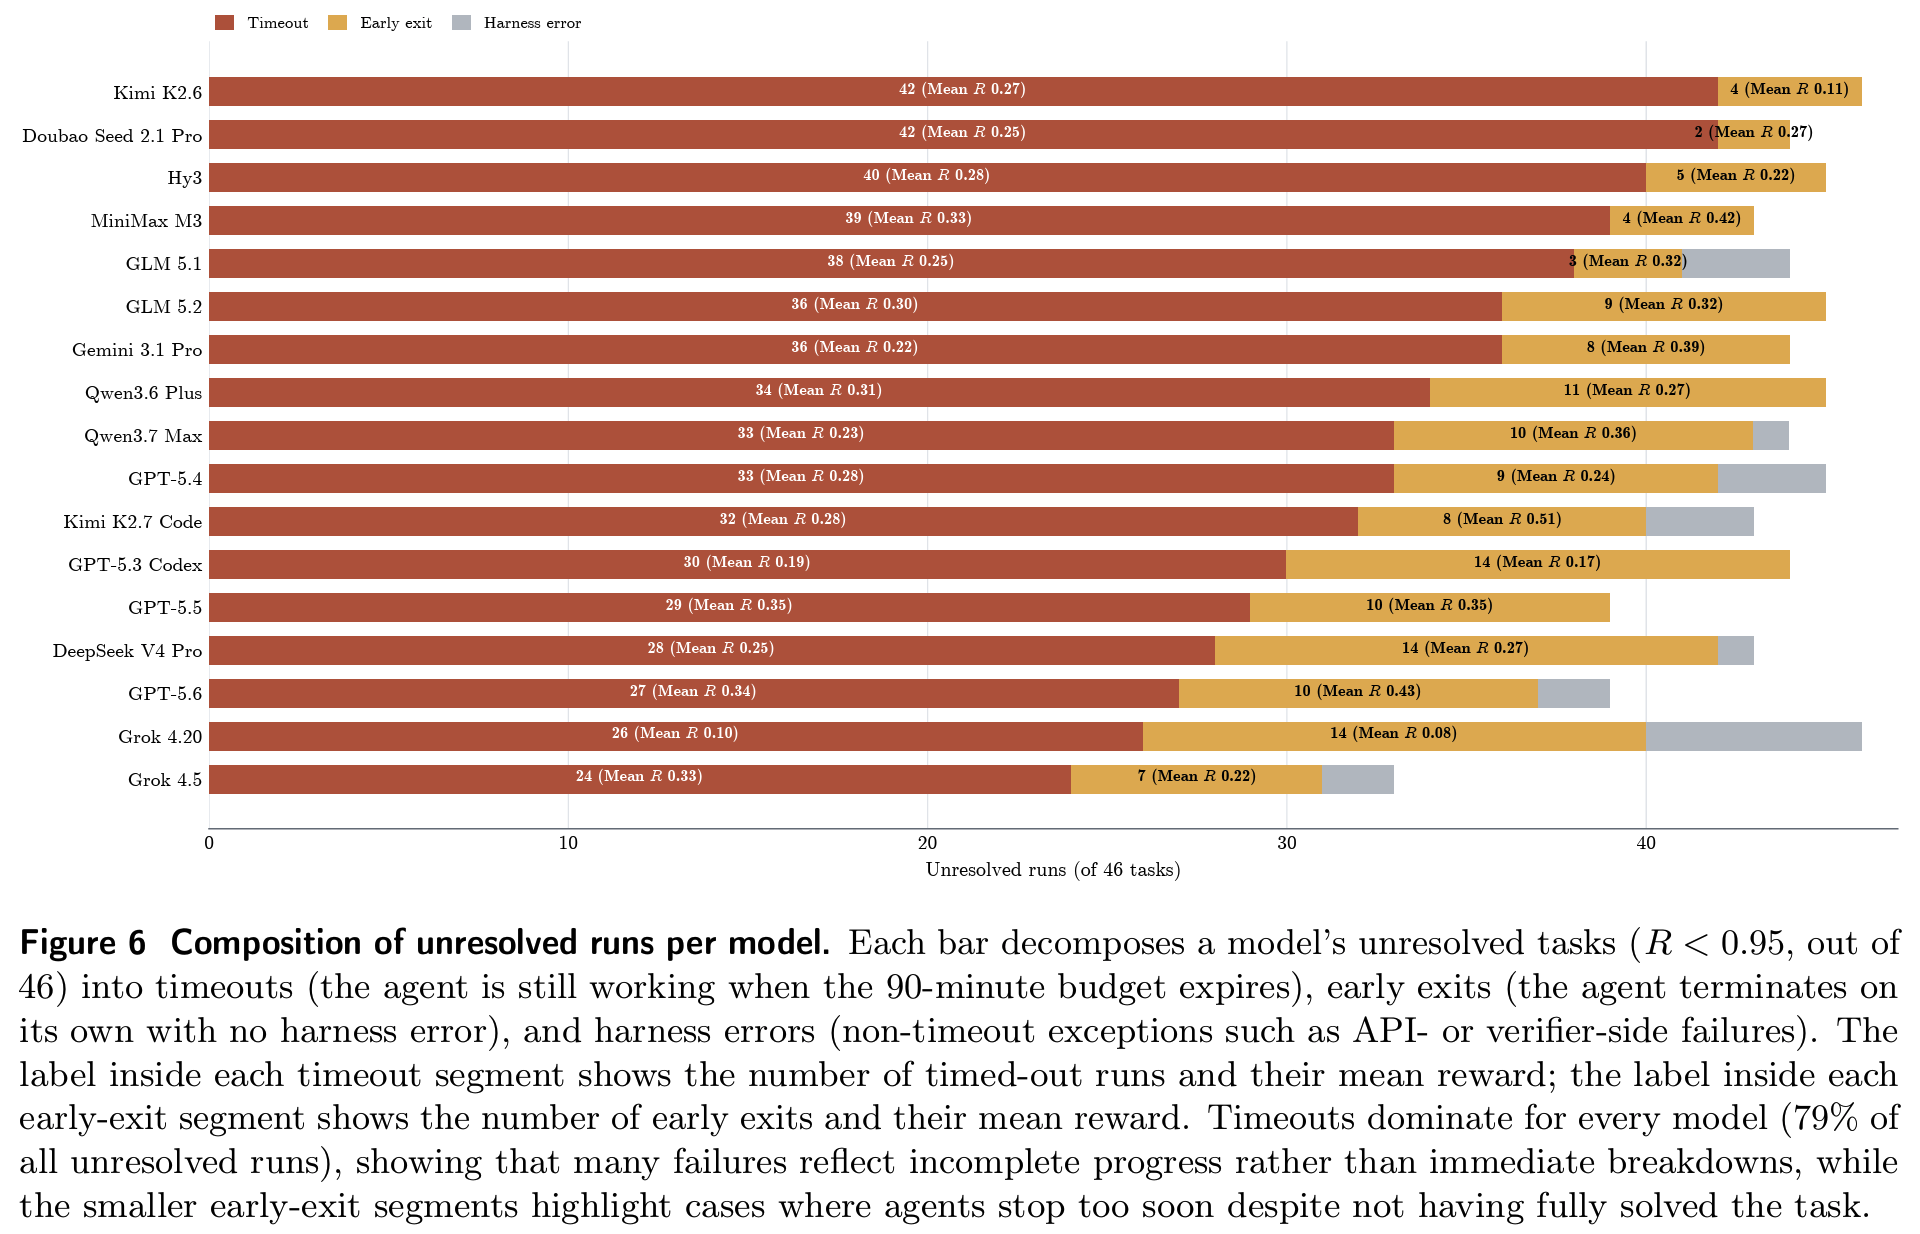
Fig 6: 병목은 local 실행 정확도가 아니라 long-horizon 완수- 미해결 run의 주 원인은 budget 소진 중인 timeout (본문 기준 79%, 518/660)
- timeout run의 mean R은 모델별 0.10에서 0.35 → 완수 직전이 아니라 진행 도중
- 스스로 종료한 early exit 약 19%, harness error 약 3%
- TB2(대부분 20분 이내)에서는 명세 불이행, step 반복, 종료 조건 누락 같은 실행 오류가 주였던 것과 대비
- 저자 해석: 순위가 task 해결 능력뿐 아니라 고정 budget 안에 reward를 쌓는 time efficiency를 반영
- 중복 탐색 감소, state 보존, 반복 검증 loop 회피가 single-step reasoning 개선보다 이득이 클 수 있음
- 미해결 run의 주 원인은 budget 소진 중인 timeout (본문 기준 79%, 518/660)
- Finding 4
Fig 6: false finish, 거의 다 해놓고 끝났다고 판단하더라- false finish: 높은 reward에서 early exit했지만 hidden verifier 통과 실패
- Kimi K2.7 Code가
duckdb-optimizer-closure에서 R = 0.92로 종료 - GLM 5.2가
apex-ib244-matter에서 R = 0.90로 종료 apex-law433-matter에서는 서로 다른 7개 모델이 R 0.80에서 0.87 사이(약 20분 남기고 종료하더라)
- Kimi K2.7 Code가
- early exit 시점 평균 R로 stopping judgment 차이가 드러남
- Kimi K2.7 Code 0.51, MiniMax M3 0.42로 늦게 멈춤 vs 다른 모델 0.22에서 0.39; Kimi K2.6은 0.11에서 포기
- false finish: 높은 reward에서 early exit했지만 hidden verifier 통과 실패
- 연구 결론) 보통 완료 정도를 체계적으로 과대평가하고 final verification에 투자를 덜 함
- TB2 taxonomy의 premature termination, weak verification의 long-horizon 버전
- 해결 방향으로 planning, memory와 progress tracking, calibration된 stopping decision 제시
Personal note. 지난주 terminal-bench 소개드리면서 중간에 무엇을 기록하든 action-level은 scoring에 반영되지 않는 평가방식을 취한다고 정리했었는데, 이 연구는 마찬가지로 action-level은 안보지만, 길이가 매우 길어서 (정확히 tb2의 task 여러개를 이어 붙인 건 아닐지라도) (sub) task-level의 scoring을 하겠다는 점에서 process를 본다고 주장한 것 같습니다.
그래서 주장하고 있는 dense reward도 RL에서 step마다 붙는다는 느낌으로 처음에 이해했는데,
Fig 1의 “process reward“라는 표현은 좀 과하고 (그렇게 보긴 어렵고), 정확히는 trajectory-level process supervision보다 subgoal-decomposed outcome evaluation에 가깝다고 보입니다.같은 harbor 형식에 terminus-2 그대로 쓰고 task당 거의 10M token쓴다는데 최소 1회 run 안에서 hand off 요약이 수차례는 발생할테니 암묵적인 세션스러운(?) 경계가 terminal-bench보다 훨씬 자주 생긴다고 간주할 수 있겠습니다. 연구 결론에서 memory와 progress tracking을 해법으로 꼽으면서도 당연한건지 현상 보고에 그친 점.. 앞선 약간 프레이밍이 과했던 것 포함 여러모로 조금 아쉬운 부분이 있습니다.