It’s All Connected: A Journey Through Test-Time Memorization, Attentional Bias, Retention, and Online Optimization
- Authors: Ali Behrouz, Meisam Razaviyayn, Peilin Zhong, Vahab Mirrokni
- Affiliation: Google Research
- Paper: https://arxiv.org/abs/2504.13173
- Published: April 17, 2025 (arXiv preprint)
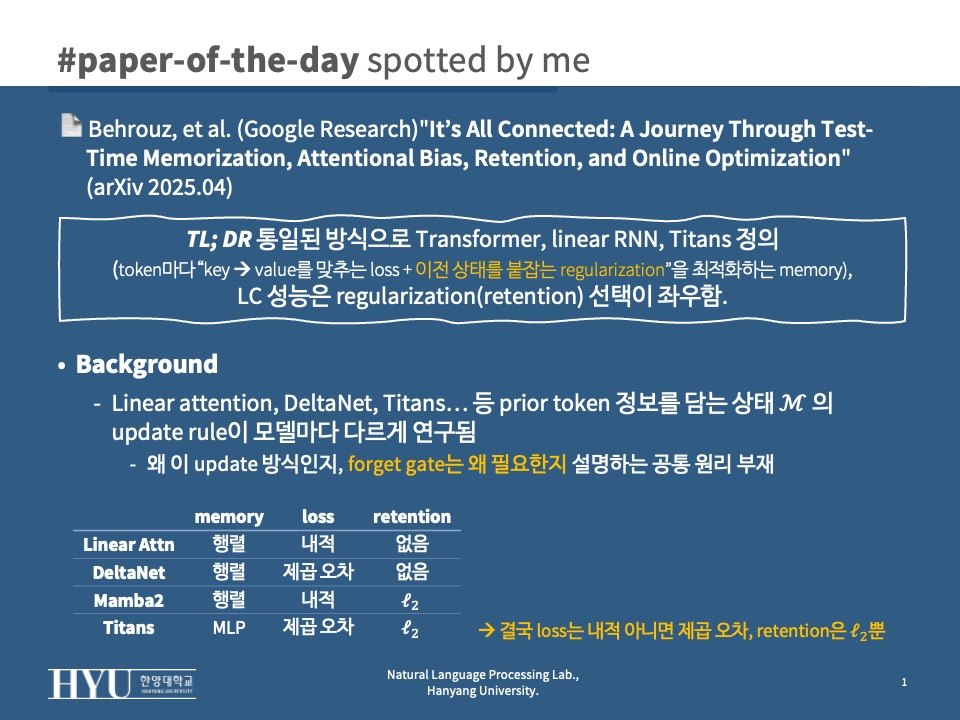
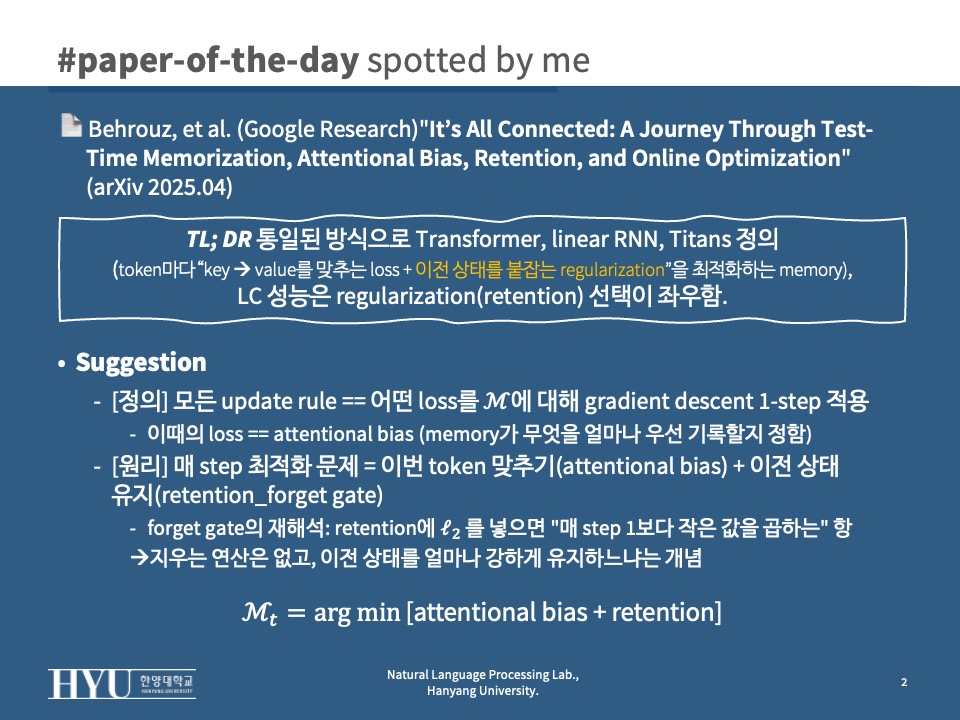
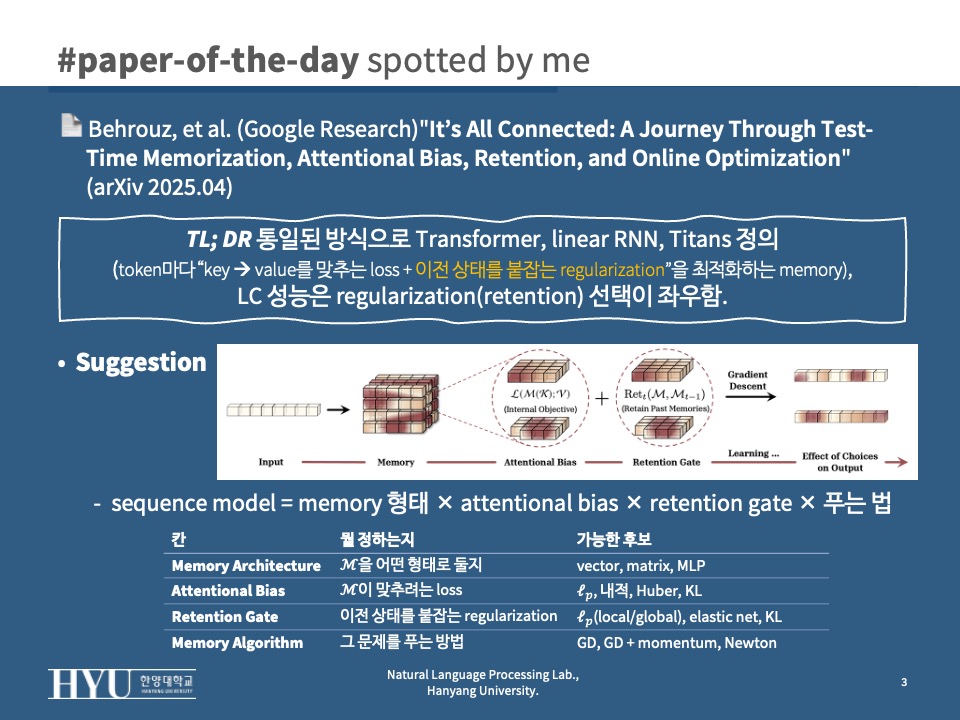
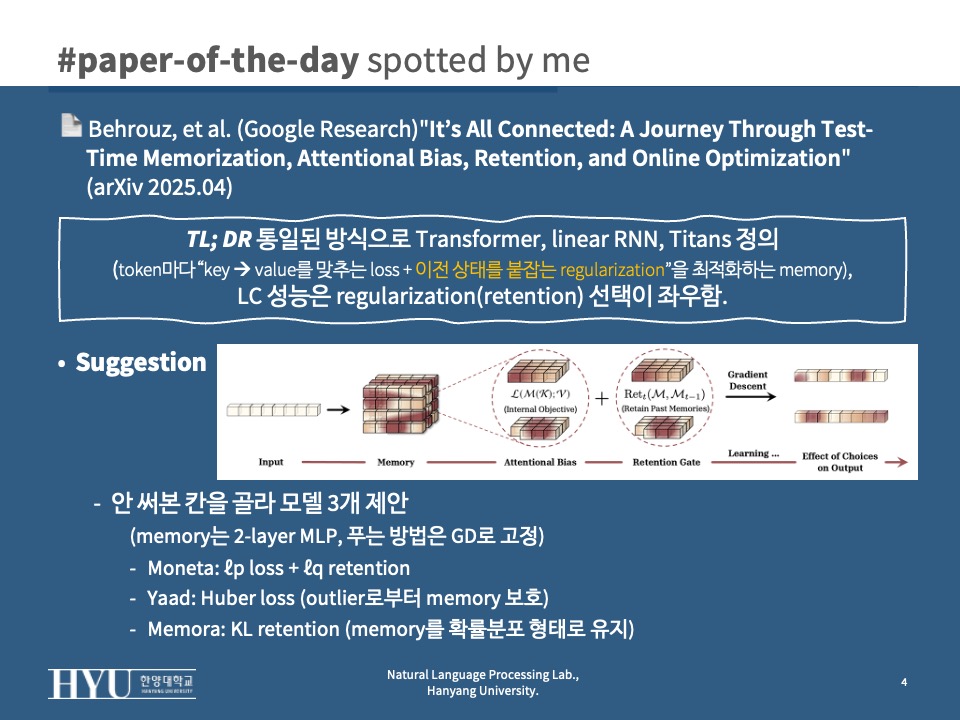
TL; DR
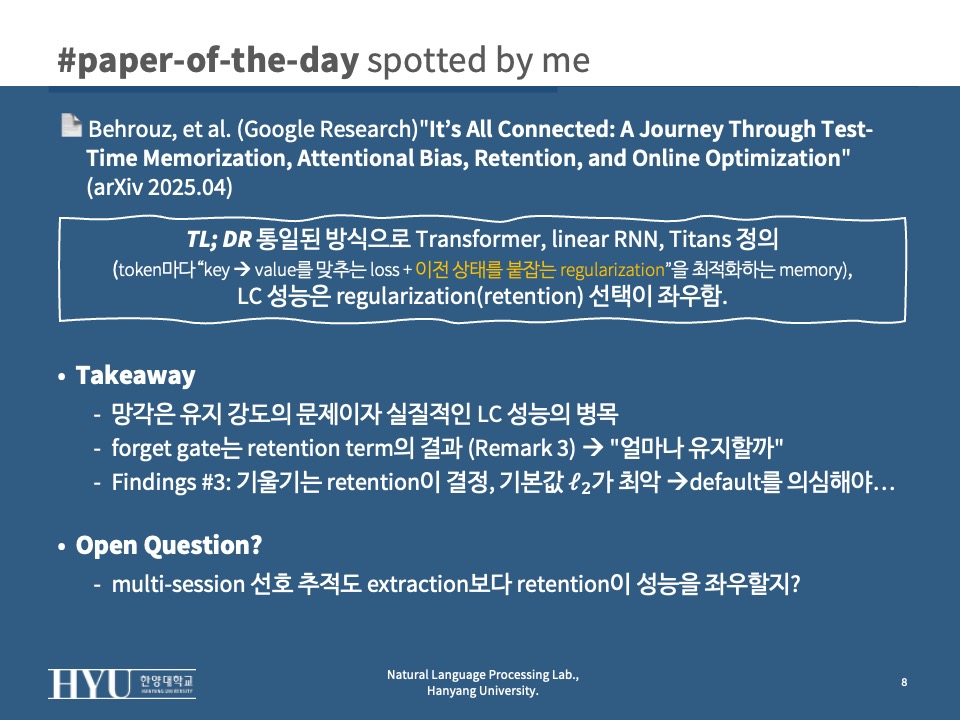
sequence model은 전부 '이번 token을 맞추는 loss + 이전 상태를 유지하는 regularization'을 token마다 푸는 것으로 정의할 수 있고, 그중 LC 성능을 좌우하는 건 regularization 쪽(retention)이다. (retention 설계를 유의해야 한다.)
Review Video
Background
- language model은 다음 token 예측에 앞 token들의 정보가 필요
- 모델마다 다른 점: 이 정보를 어떤 형태로 저장하고, 새 token이 올 때 어떻게 갱신하는가
- Transformer (Vaswani et al., 2017): 지나간 token마다 key $\mathbf{k}$, value $\mathbf{v}$를 따로 전부 저장 (KV cache)
- 새 token의 query $\mathbf{q}$를 저장된 모든 key와 비교하고, 유사도에 비례해 value를 섞어서 가져옴
- 정확하지만 길이에 비례해 저장 공간이 늘고, 비교 연산은 길이의 제곱으로 증가
- Linear attention 계열: softmax를 빼면 출력을 행렬 하나로 미리 합쳐둘 수 있음
- Linear Attention (Katharopoulos et al., 2020), RetNet (Sun et al., 2023), GLA (Yang et al., 2024b), Mamba2 (Dao & Gu, 2024)
- $o_t = \sum_i (\mathbf{k}_i^\top \mathbf{q}_t)\mathbf{v}_i = (\sum_i \mathbf{v}_i \mathbf{k}_i^\top)\mathbf{q}_t$: 괄호 안은 query와 무관하므로 행렬 $\mathcal{M}_t$로 누적 가능
- 쓰기: $\mathcal{M}t = \mathcal{M}{t-1} + \mathbf{v}_t \mathbf{k}_t^\top$ / 읽기(= attention 출력 계산): $\mathcal{M}_t \mathbf{q}_t$
- 읽기가 되는 이유: $\mathbf{q}$가 예전에 넣은 key와 같고 key끼리 직교하면, 나머지 항은 내적이 0이 되어 해당 value만 남음
- 길이와 무관하게 계산량 일정; RetNet, Mamba2 등은 매 스텝 $\mathcal{M}$에 1보다 작은 값을 곱해 오래된 내용을 줄임 (forget gate)
- 한계: 더하기만 하므로 서로 직교할 수 있는 key 수(행렬 차원)를 넘으면 value들이 섞여 읽기가 오염
- Linear Attention (Katharopoulos et al., 2020), RetNet (Sun et al., 2023), GLA (Yang et al., 2024b), Mamba2 (Dao & Gu, 2024)
- Delta rule 계열: 쓰기 전에 현재 $\mathcal{M}$이 이 key에 내놓는 값 $\mathcal{M}\mathbf{k}_t$를 확인하고, 원하는 value와의 차이만큼만 더함
- DeltaNet (Schlag et al., 2021), Gated DeltaNet (Yang et al., 2024a), RWKV-7 (Peng et al., 2025)
- $\mathcal{M}t = \mathcal{M}{t-1} + \eta_t(\mathbf{v}t - \mathcal{M}{t-1}\mathbf{k}_t)\mathbf{k}_t^\top$: 이미 맞는 value를 내놓고 있으면 거의 변하지 않고, 틀리게 내놓고 있으면 그만큼 수정
- 한계: 여전히 행렬이라 담을 수 있는 양이 제한되고 long context에서 성능 하락; 이론적 표현력 제약도 지적됨 (Irie et al., 2023)
- Titans (Behrouz et al., 2024): 본 연구의 직접한 선행연구, 상태 $\mathcal{M}$을 행렬 대신 작은 MLP로 둠
- token마다 $\lVert \mathcal{M}(\mathbf{k}_t) - \mathbf{v}_t \rVert_2^2$의 gradient로 MLP weight를 갱신 → inference 중에도 이 MLP는 계속 학습됨 (test-time memorization)
- gradient가 클수록(현재 MLP가 이 token을 잘 못 맞힐수록) 크게 갱신; 논문은 이 gradient를 surprise라 부름
-
momentum으로 직전 token들의 gradient를 누적 반영, weight decay $(1-\alpha_t)$로 오래된 내용을 줄임 (= forget gate)
\[\mathcal{M}_t = (1 - \alpha_t)\mathcal{M}_{t-1} + S_t, \quad S_t = \eta_t S_{t-1} - \theta_t \nabla \ell(\mathcal{M}_{t-1}; x_t)\] - MLP weight는 inner loop에서 갱신, key/value projection 등 나머지 parameter는 일반 학습(outer loop)
- 남긴 질문: 왜 하필 제곱 오차인가, weight decay 말고 다른 망각 방식은 없는가
- 통합 framework 시도들: 각자 일부만 포괄
- SSD (Dao & Gu, 2024): 더하기만 하는 Linear attention 계열만 포괄
- Longhorn (Liu et al., 2024a): online learning 관점이나 행렬 memory로 한정; Transformer, Titans는 설명 불가
- TTT (Sun et al., 2024): linear/softmax attention을 regression loss의 해로 해석, 다른 linear RNN은 제외
- Test-time regression (Wang et al., 2025, concurrent): 모든 모델을 regression으로 단순화 → 내적과 제곱 오차의 차이가 지워짐
- 쓰기 규칙, forget gate, memory 형태가 모델마다 따로 개선되어 왔고 이를 하나로 설명하는 설계 원리가 없다.
- 특히 forget gate가 왜 필요하고 무엇으로 대체할 수 있는지는 거의 다루지 않더라…
Problem States
- 다양하게 설명하고 있는 모델들을 같은 형태로 기술한 정의가 없다
- forget gate가 경험적 장치로만 쓰여 대안을 설계할 근거가 없다
- 기존 모델은 맞출 loss가 내적 아니면 제곱 오차, 유지 penalty가 L2 계열로 사실상 고정된다
- 흔히 쓰는 선택이지만 데이터의 noise에 민감
- 제곱 오차는 오차가 2배면 갱신도 2배
- 동떨어진 token 하나(outlier)가 $\mathcal{M}$을 크게 변동시킬 수 있음
- 다른 loss를 쓰면 update rule이 비선형이 되어 병렬 학습이 어려움
- 흔히 쓰는 선택이지만 데이터의 noise에 민감
- [정의] 모든 모델을 같은 언어로 쓰는 associative memory + attentional bias
- [원리] forget gate를 최적화 문제의 항으로 설명하는 Learning-Retaining 관점
- [대안] 표준 밖 attentional bias와 retention gate
- [구현] 이를 조합한 Moneta, Yaad, Memora와 chunk 단위 병렬 학습
Suggestions
[정의] Associative Memory & Attentional Bias
- update rule: 새 token $(\mathbf{k}t, \mathbf{v}_t)$가 들어왔을 때 직전 상태 $\mathcal{M}{t-1}$로부터 새 상태 $\mathcal{M}_t$를 계산하는 식
- 모델마다 이 식이 다름: Background의 Linear attention 쓰기 식, DeltaNet 식, Titans 식이 각각의 update rule
- 이 논문의 관찰은 이 식들이 모두 아래 형태(gradient descent 한 번)로 쓰인다는 것
- 출발 관찰: Background의 update rule들은 모두 어떤 loss를 $\mathcal{M}$에 대해 gradient descent를 딱 한 번 적용한 결과와 같음
- DeltaNet: 제곱 오차 $\lVert \mathcal{M}\mathbf{k}_t - \mathbf{v}_t \rVert_2^2$를 한 gradient descent
- Linear attention: 내적을 키우는 loss $-2\langle \mathcal{M}\mathbf{k}_t, \mathbf{v}_t \rangle$를 한 gradient descent
- 즉 상태 갱신 = token이 들어올 때마다 작은 최적화 문제를 세우고 그걸 한 스텝 gradient descent
- associative memory: key 집합 $\mathcal{K}$를 value 집합 $\mathcal{V}$로 보내는 mapping $\mathcal{M}$ (Def. 3.1)
-
이 mapping이 맞춰야 할 loss $\mathcal{L}$이 attentional bias: loss의 형태가 memory가 무엇을 얼마나 우선 기록할지를 정함 (인지심리학 용어에서 차용)
\[\mathcal{M}^* = \arg\min_{\mathcal{M}} \mathcal{L}(\mathcal{M}(\mathcal{K}); \mathcal{V})\]- inner loop에서 attentional bias를 최적화하며 memory weight만 갱신, outer loop에서 나머지 parameter 학습 (Remark 2)
-
[원리] Learning-Retaining Viewpoint
-
매 스텝 최적화 문제에 “이번 token을 맞춰라” 외에 “이전 상태를 너무 버리지 마라”는 항이 함께 필요
\[W_t = \arg\min_{W} \tilde{\ell}_t(W; \mathbf{k}_t, \mathbf{v}_t) + \frac{1}{\eta_t}\mathcal{D}_t(W, W_{t-1}) + \frac{1}{\alpha_t}\mathcal{G}_t(W)\]- $\tilde{\ell}_t$ (attentional bias): 이번 key-value 쌍을 맞추는 loss
- $\mathcal{D}_t$ (local retention): 직전 상태에서 멀어지는 것에 대한 벌점; $\eta_t$가 클수록 새 token을 많이 반영
- $\mathcal{G}_t$ (global retention): memory 크기 자체에 대한 벌점; 두 항을 합쳐 retention gate
- forget gate의 재해석: $\mathcal{G}_t$에 $\lVert W \rVert_2^2$ 같은 regularization을 넣고 풀면 “매 스텝 $W$에 1보다 작은 값을 곱하는” 항이 자동으로 생김
- forget gate는 지우기 위해 따로 만든 장치가 아니라 penalty 항에서 나온 결과
- 이 관점에는 지우는 연산이 없고 이전 상태를 얼마나 강하게 유지하느냐만 있음 (Remark 3) → forget gate 대신 retention gate라 명명
- FTRL 관점(모든 token loss 합 + regularizer)과의 관계: retention을 Bregman divergence로 두면 같은 update rule (Proposition 3.2)
- Bregman divergence: 함수 $h$를 $W’$에서 1차 근사했을 때 실제 $h(W)$와의 차이; $h$가 제곱 norm이면 일반 거리 제곱
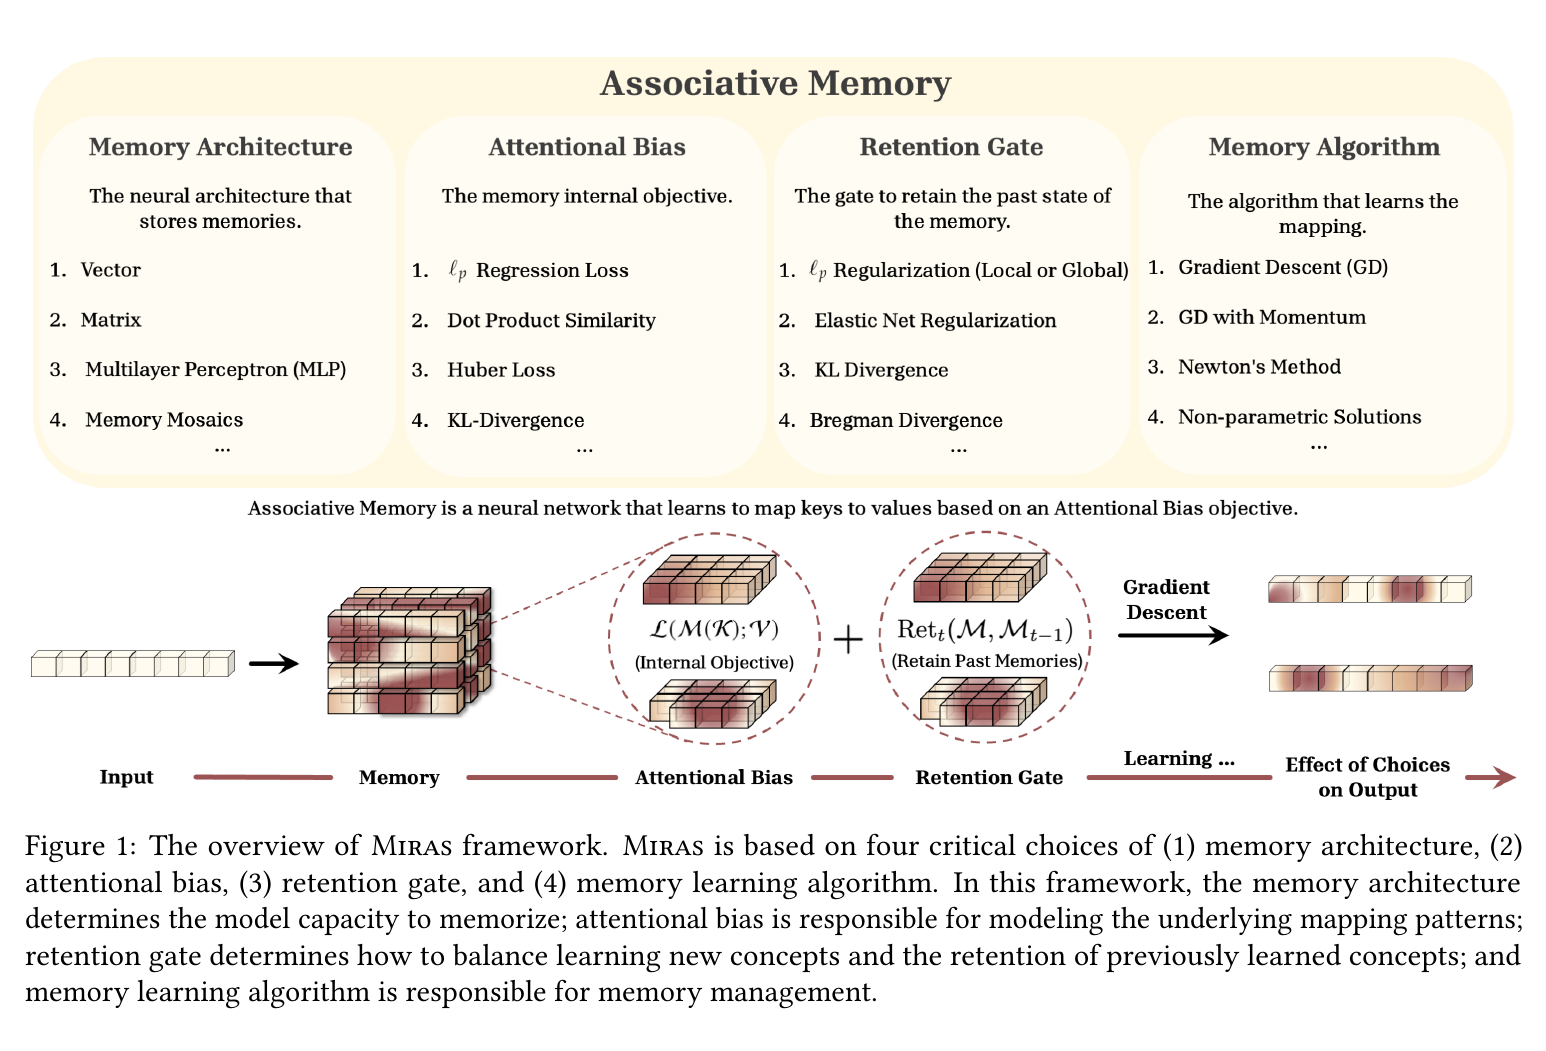
[대안] Miras: 네 가지 design choice Fig 1, Tab 1
- 하나의 sequence model = 네 가지 선택의 조합
- ($\mathcal{M}$이 어떤 형태인가) Memory Architecture: 상태의 형태 (vector, matrix, MLP, ….)
- (어떤 loss를 쓰나) Attentional Bias: 맞출 loss (내적, 제곱 오차, $\ell$p, Huber, KL 등)
- (어떤 regularization term을 쓰나) Retention Gate: 이전 상태 유지 벌점 ($\ell$2, elastic net, KL, Bregman 등)
- (최적화 문제를 어떤 방법으로 푸나) Memory Algorithm: 푸는 방법 (GD, momentum, Newton, nonparametric 등)
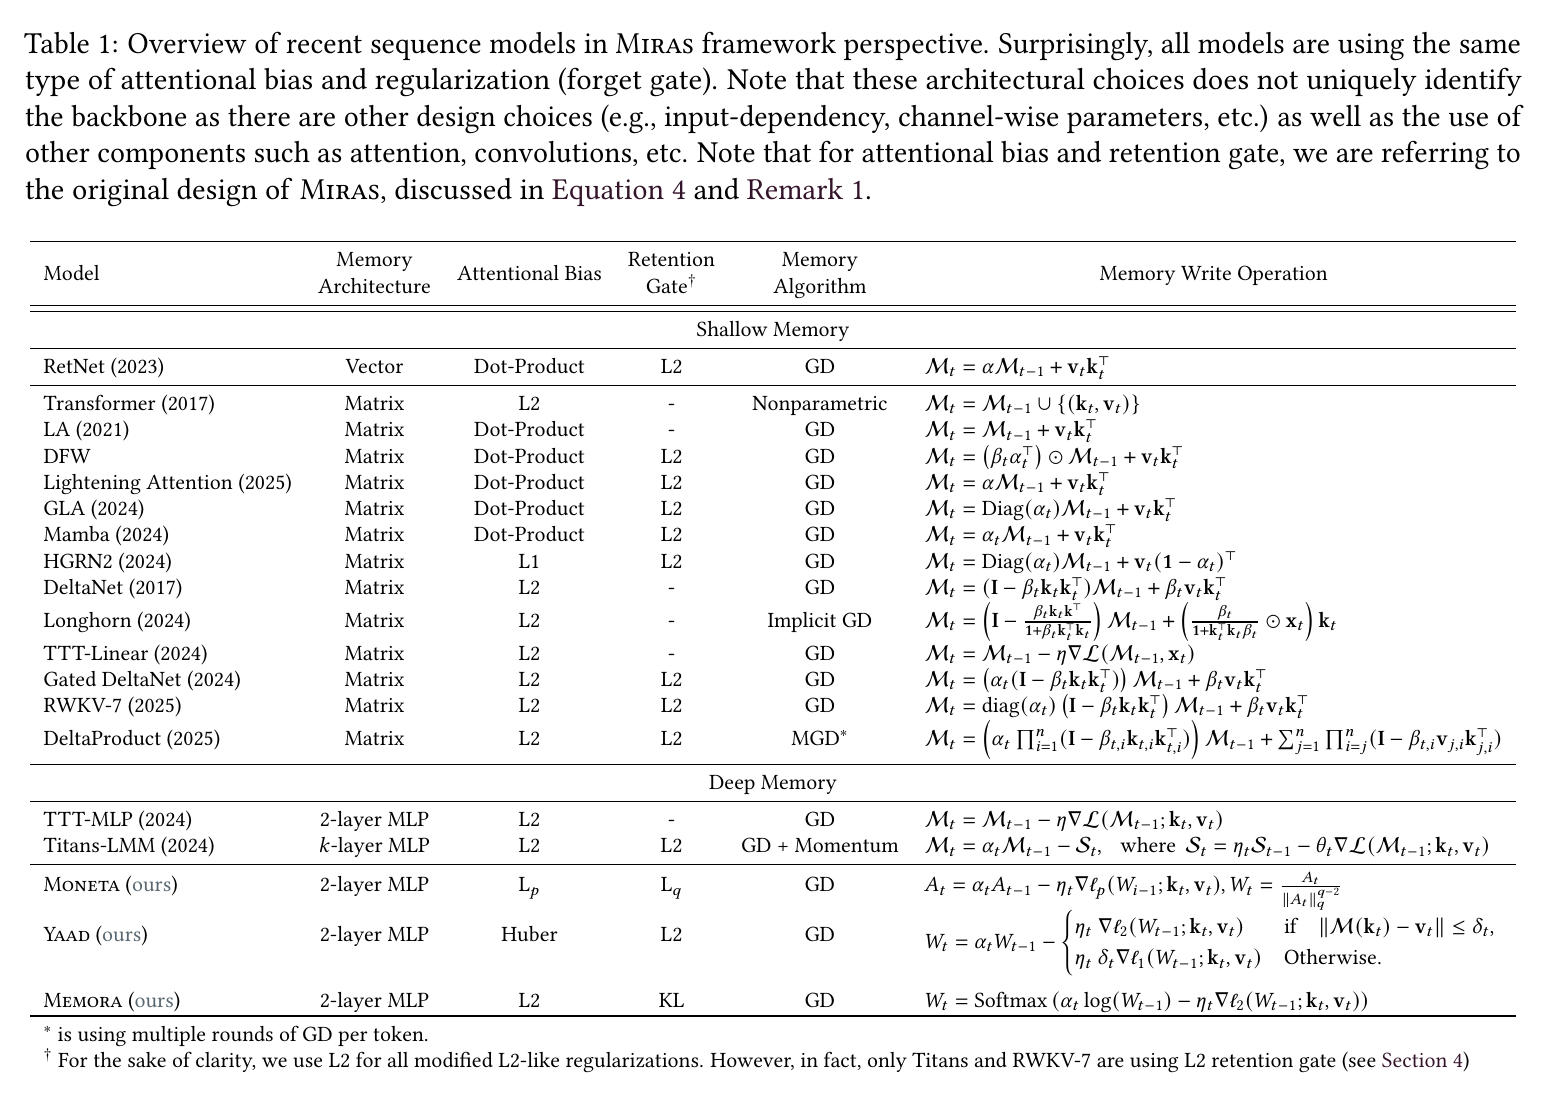
- 기존 모델 재해석
- 내적 + 행렬: 감쇠 없으면 Linear Attention, 학습된 상수면 RetNet, 입력에 따라 변하면 Mamba2
- 제곱 오차 + 행렬: 감쇠 없으면 DeltaNet, scalar gate면 Gated DeltaNet, channel별이면 RWKV-7
- 제곱 오차 + MLP + local/global $\ell$2 + momentum: Titans
- 제곱 오차의 nonparametric 닫힌 해(Nadaraya-Watson): softmax attention
- 관찰: 거의 모든 모델이 loss로 내적 아니면 제곱 오차, retention으로 $\ell$2 계열만 사용
- 단 표의 $\ell$2 retention은 “$\ell$2와 유사한 변형”까지 포함하며, 엄밀히는 Titans, RWKV-7뿐이라고 각주로 밝힘
#1 Alternative Attentional Biases
- 아래는 attentional bias로 고를 수 있는 선택지 목록 (셋을 함께 쓰는 것이 아님)
- 실제 모델에 쓰인 것: $\ell$p → Moneta, Huber → Yaad / robust value-shift loss는 제안만 하고 실험에는 미사용
- $\ell$p loss: $\lVert \mathcal{M}(\mathbf{k}_t) - \mathbf{v}_t \rVert_p^p$
- $p = 1$이면 오차의 부호만 남아 value를 ±1 두 값으로만 기록 (value-less associative memory)
- Sign, 절댓값은 $\tanh(\alpha x)$, $\sqrt{x^2 + \epsilon}$로 근사 (Remark 5)
- Huber loss: 오차가 $\delta_t$ 이하면 제곱 오차, 넘으면 절댓값 오차 → 오차가 커져도 갱신 크기가 일정 수준 이상 커지지 않음
- $\delta_t$가 입력에 따라 달라지므로 token마다 어느 loss를 쓸지 모델이 정함
- value shift에 robust한 loss: 정답 value가 반경 $\Delta$ 안에서 최악으로 흔들려도 맞추도록 min-max
- 닫힌 형태 $\frac{1}{2}\lVert e \rVert_2^2 + \Delta \lVert e \rVert_2 + \frac{1}{2}\Delta^2$: 제곱 오차에 오차 크기 항이 더해진 꼴
#2 Alternative Retention Gates
- 아래도 retention gate 선택지 목록
- 실제 모델에 쓰인 것: $\ell$q → Moneta, KL → Memora / elastic net, Bregman은 실험에 미사용
- KL retention: $W$를 음수가 아니고 합이 $c$인 확률분포처럼 다루고 직전 분포와의 KL을 penalty로
- global retention은 Shannon entropy
- 직전 상태의 log에서 gradient를 빼고 다시 정규화
- $\lambda_t$가 log 값을 줄여 분포를 평평하게 만드는 것이 망각
- elastic net retention: $\ell_2 + \ell_1$ 벌점 → $\lambda$ 곱은 서서히 줄이는 망각, soft thresholding($\gamma$ 이하를 0으로)은 완전히 지우는 망각
- ℓq retention: gradient를 $A_t$에 누적하고 $W_t = A_t / \lVert A_t \rVert_p^{p-2}$로 정규화
- Bregman retention: $W_t = g(-\eta \nabla \ell + F’(W_{t-1}))$; $g$가 sigmoid면 memory 성분이 항상 (0, 1) 안에 머묾
[구현] Moneta, Yaad, Memora (→ Miras)
- 앞선 #1, #2 선택지 중 일부를 실제로 조합해 만든 모델 3개 제안: attentional bias와 retention gate만 다르게 선택
- 공통: 네 가지 선택 중 memory 형태(2-layer MLP)와 풀이 방법(GD)은 셋 다 동일
- 2-layer MLP memory $\mathcal{M}(x) = x + \mathrm{LN}(W_1 \sigma(W_2 x))$, GD, learning rate $\eta$와 retention 강도 $\alpha$를 분리
- 공통: 네 가지 선택 중 memory 형태(2-layer MLP)와 풀이 방법(GD)은 셋 다 동일
- Moneta: $\ell$p loss + $\ell$q retention, $(p, q) = (3, 4)$
- memory: gradient 누적 $A_t$를 $\ell$q norm으로 정규화한 것
- Yaad: Huber loss + Titans와 같은 local/global retention, momentum 없음
- outlier로부터 memory 보호
- Memora: 제곱 오차 + KL retention
- memory를 확률분포 형태로 유지 (수치 안정성 목적)
- Training
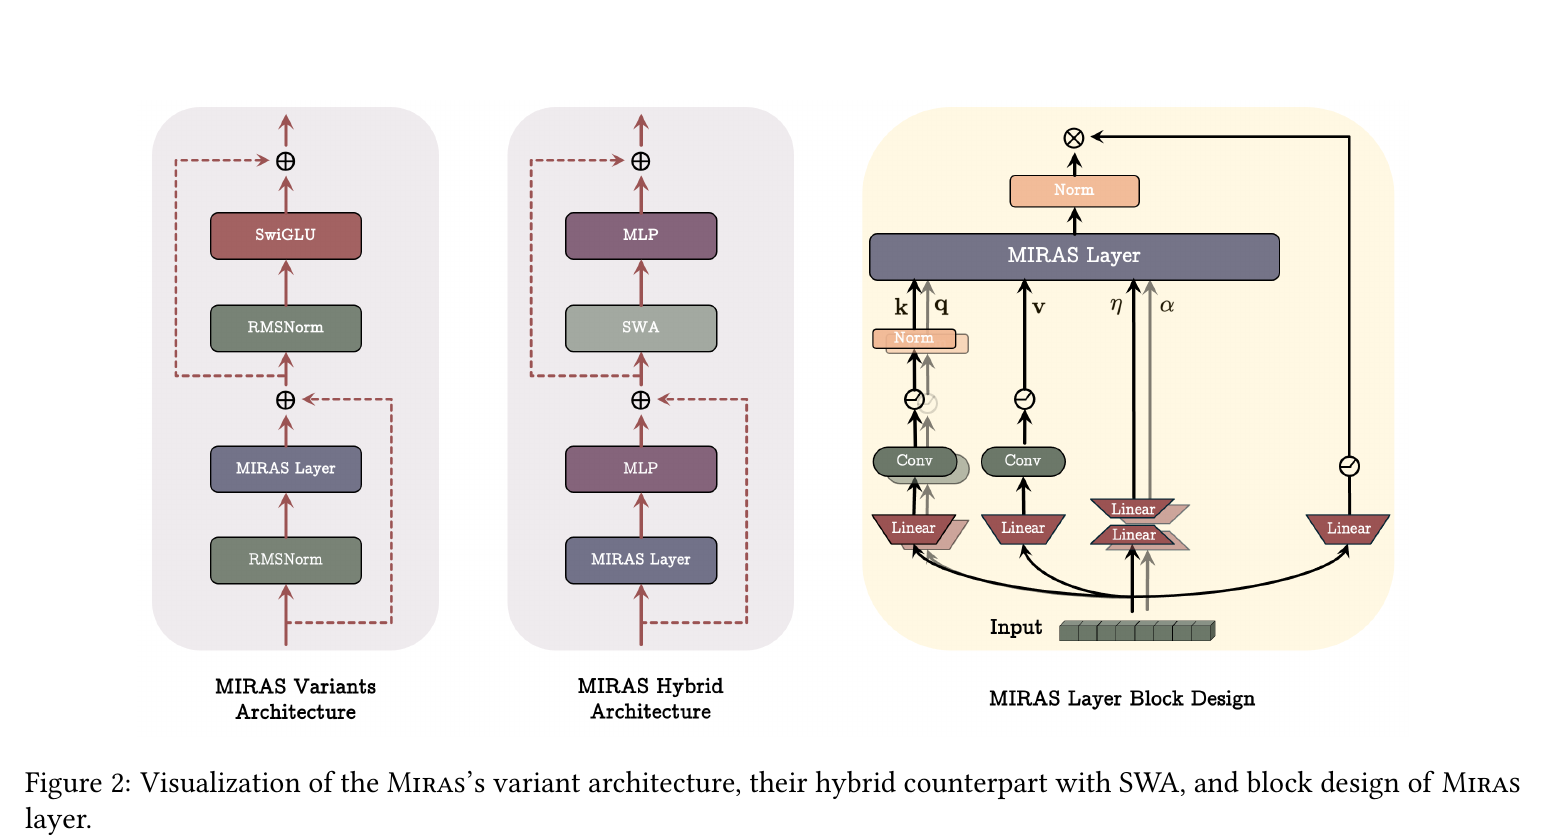
Fig 2: 앞선 3종의 실제 language model로 만들고 대규모로 학습하기 위한 구현- Backbone: Llama 구조에서 attention만 Miras layer로 교체
- Miras layer: 각 token의 q, k, v를 만들고, update rule으로 $\mathcal{M}$을 갱신한 뒤 $\mathcal{M}(\mathbf{q}_t)$를 출력하는 layer (Moneta, Yaad, Memora는 이 layer 3가지 종류인 것 !) (성능 분석 명확히 하기 위함)
- q, k, v 뒤 token끼리 섞는 depthwise conv (linear RNN-st.)
- q와 k는 값이 너무 커지지 않도록 $\ell$2 normalize
- $\eta_t, \delta_t, \alpha_t$ (얼마나 반영할지, Huber 임계값, retention 강도)는 fixed되지 않은 channel별 값, low-rank projection으로 parameter 증가 억제
- hybrid(-H): Samba (Ren et al., 2024) 방식으로 Miras layer와 sliding window attention과 순차 결합 (Memora-H, …)
- Miras layer: 각 token의 q, k, v를 만들고, update rule으로 $\mathcal{M}$을 갱신한 뒤 $\mathcal{M}(\mathbf{q}_t)$를 출력하는 layer (Moneta, Yaad, Memora는 이 layer 3가지 종류인 것 !) (성능 분석 명확히 하기 위함)
- 병렬화:
- update rule에서 $\mathcal{M}t$를 구하려면 $\mathcal{M}{t-1}$이 먼저 있어야 하므로…
이대로면 token 수만큼 순서대로 계산해야 함 (Transformer처럼 모든 위치를 한 번에 학습 불가) - chunk 단위 병렬화 (근사): chunk 안 모든 token의 gradient를 직전 token이 아닌 (시점 4라면 3의, 시점 5 라면 4의, …) chunk 시작 시점(chunk가 3, 4, 5, 6시점의 묶음이라면 3)의 $\mathcal{M}$(= 직전 chunk 끝의 상태) 기준으로 한꺼번에 계산 → chunk 내부는 행렬곱
- Moneta는 $\ell$q 정규화를 chunk 끝에서만, Yaad는 두 gradient를 모두 계산 후 mask로 선택
- Memora는 log와 softmax가 상쇄되므로 chunk 경계 다음 token 하나에만 비선형 갱신
- update rule에서 $\mathcal{M}t$를 구하려면 $\mathcal{M}{t-1}$이 먼저 있어야 하므로…
- Backbone: Llama 구조에서 attention만 Miras layer로 교체
Effects
- Experimental setup
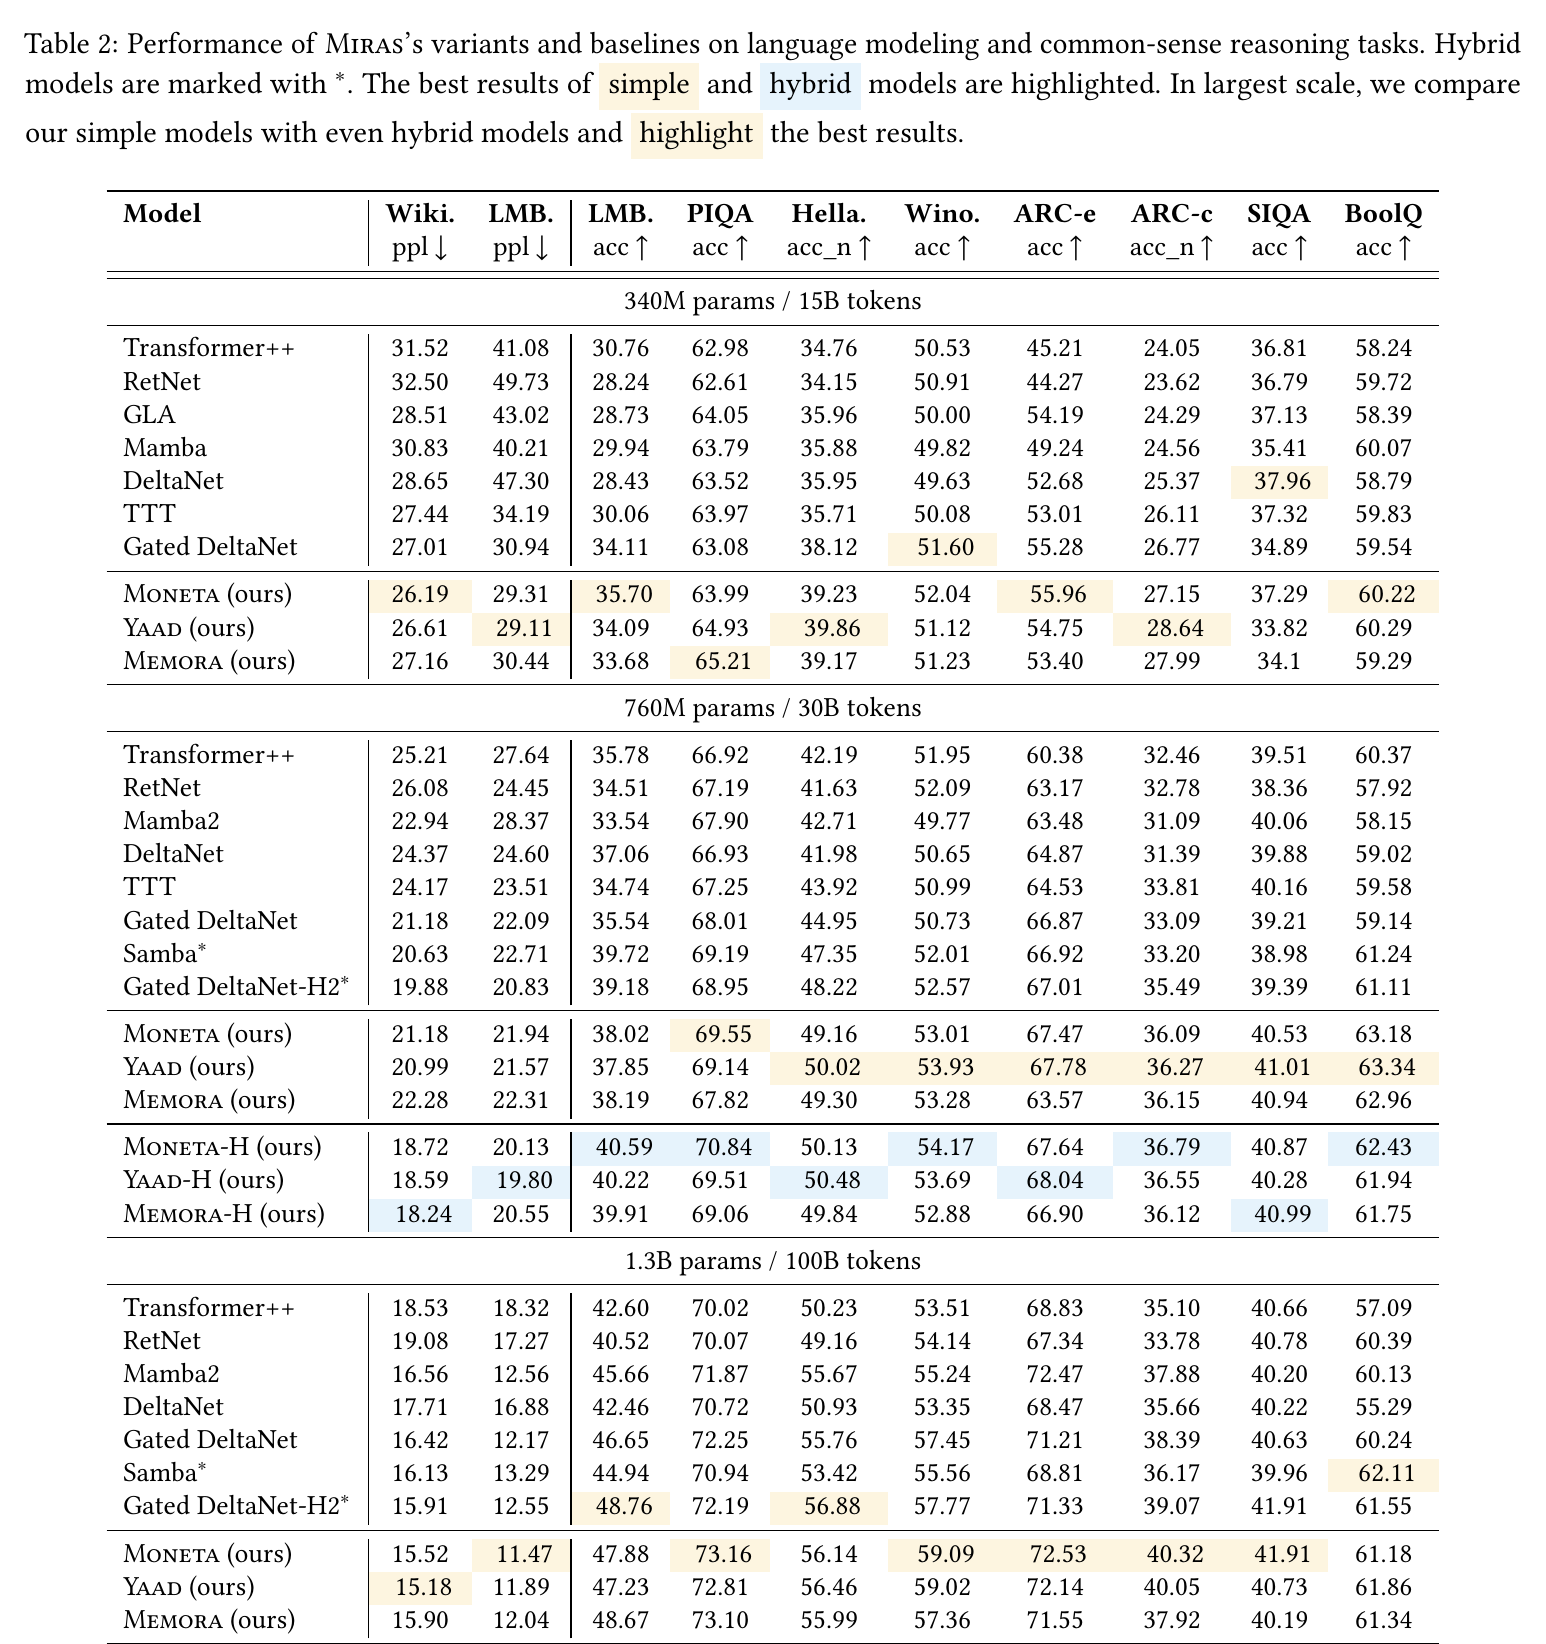
- training: context 4096, FineWeb-Edu (LM, commonsense) / C4 (scaling)
- 120M/340M (15B tokens), 760M (30B tokens), 1.3B (100B tokens)
- baselines: Transformer++, RetNet, GLA, Mamba, Mamba2, DeltaNet, TTT, Gated DeltaNet / hybrid: Samba, Gated DeltaNet-H2
- baseline 수치는 Titans 논문 보고값 재사용 (재학습 아님)
- evaluation
- LM: WikiText, LAMBADA perplexity
- commonsense: LAMBADA, PIQA, HellaSwag, WinoGrande, ARC-e/c, SIQA, BoolQ accuracy
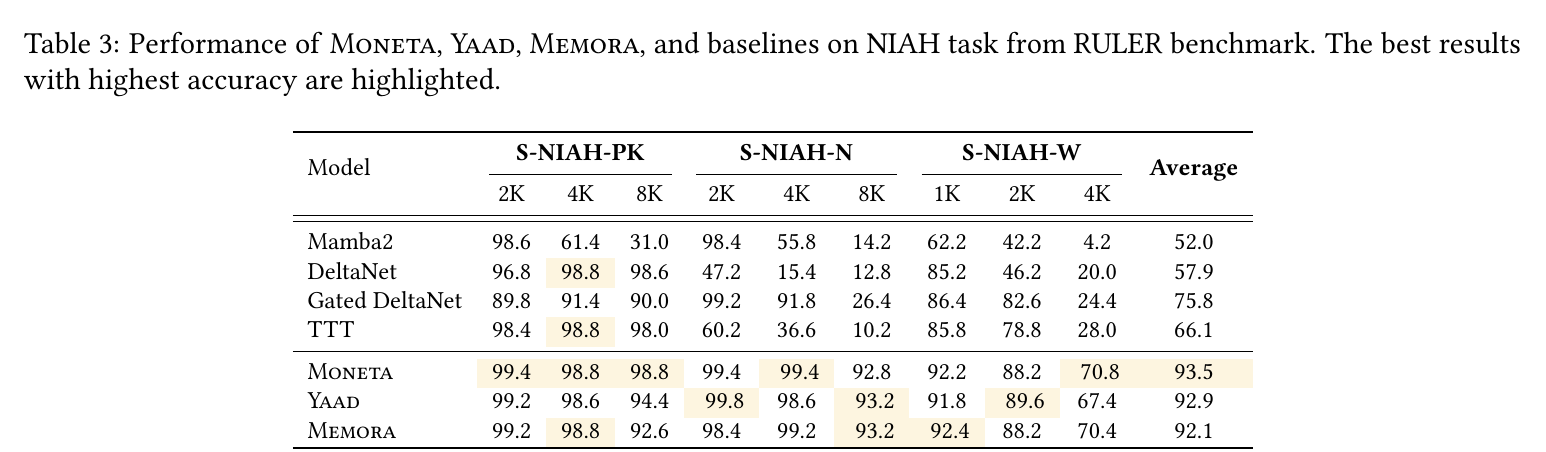
- long context: RULER의 S-NIAH(Single Needle-In-A-Haystack, 긴 입력 사이에 정보 하나를 숨겨두고 마지막에 물어 정확히 꺼내는지 보는 과제) 1K~8K
- training: context 4096, FineWeb-Edu (LM, commonsense) / C4 (scaling)
- Results
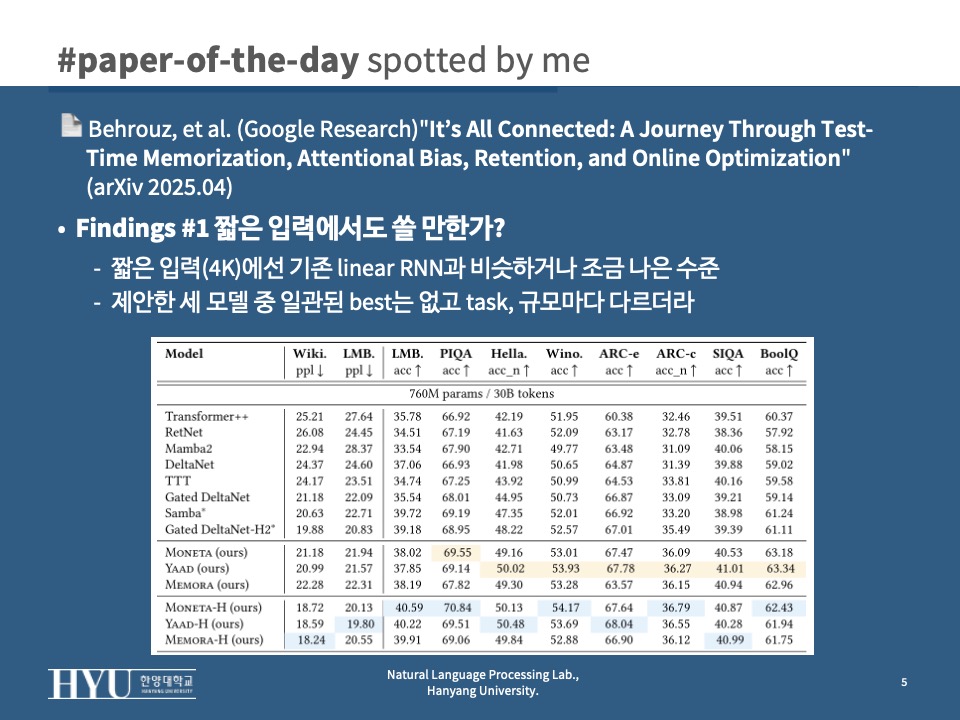
- 짧은 입력(4K)에서는 기존 linear RNN과 비슷하거나 조금 나은 수준
Tab 2- recurrent 모델끼리 비교하면 세 variant가 대체로 가장 좋음
- 세 variant 중 하나가 일관되게 best는 아니고, task와 규모에 따라 다름
- Memora는 340M에서 Gated DeltaNet보다도 못하기도!
- attention을 섞은 hybrid끼리는 Miras hybrid가 가장 좋음
- 단 pure Miras는 기존 hybrid를 넘지 못함 → attention을 완전히 대체하는 수준까지는 아님
- Transformer++보다 나은 결과는 1.3B까지 규모를 키워도 유지
- 짧은 입력에서는 memory가 넘칠 일이 적어 linear RNN끼리 차이가 원래 작음
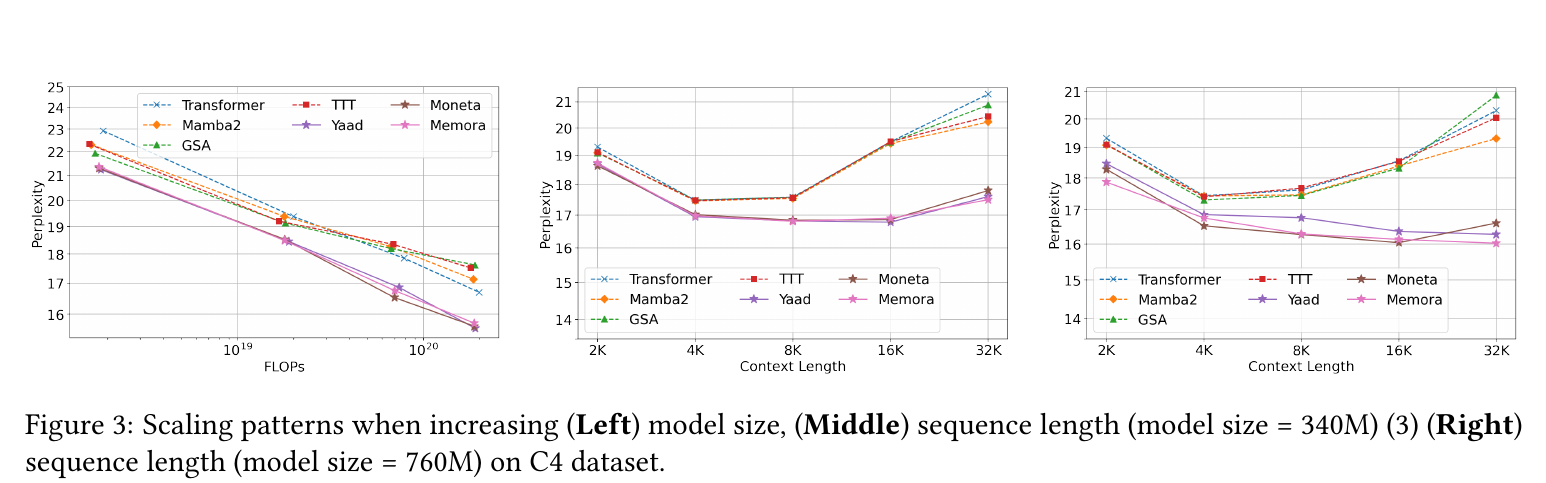
- 차이는 입력이 길어질 때 확대 (scaling)
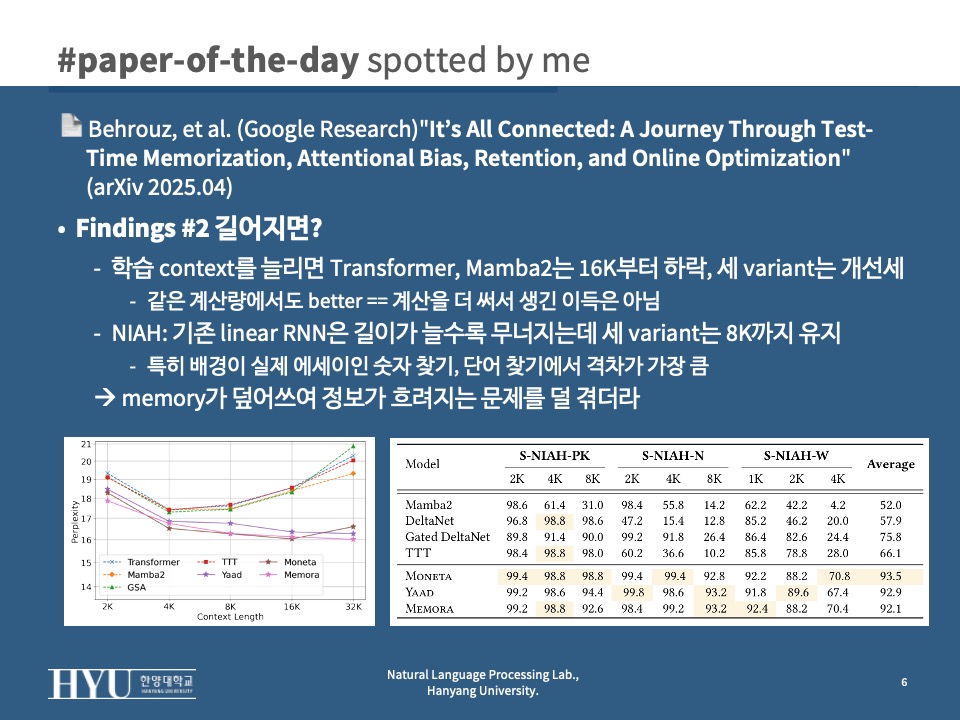
Fig 3- 학습 context를 늘리면 Transformer, Mamba2, TTT는 16K를 넘어서며 오히려 나빠지는데, 세 variant는 계속 좋아짐 → 긴 입력을 고정 크기 memory에 담는 관리가 더 잘 됨
- 같은 계산량을 썼을 때도 baseline보다 좋음 → 이득이 계산을 더 써서 생긴 것은 아님
- NIAH 과제에서 격차가 가장 큼
Tab 3- 기존 linear RNN은 길이가 늘수록 급격히 무너지는데, 세 variant는 8K까지 거의 유지
- 차이는 기존 모델이 무너지는 구간(긴 길이, 배경이 실제 에세이 텍스트인 숫자 찾기(S-NIAH-N), 단어 찾기(S-NIAH-W))에서 가장 큼 → memory가 덮어쓰여 정보가 흐려지는 문제를 덜 겪음
- 저자 주장: 같은 무의미한 문장을 반복한 배경에 숫자를 숨긴 pass-key 찾기(S-NIAH-PK)에서 Moneta가 가장 좋으므로 p-norm objective와 retention gate가 noise에 robust하다는 근거
다만 $\ell$2를 쓰는 DeltaNet도 pass-key 찾기에서 거의 만점이라 이 과제로는 그 차이를 구분하기 어려움
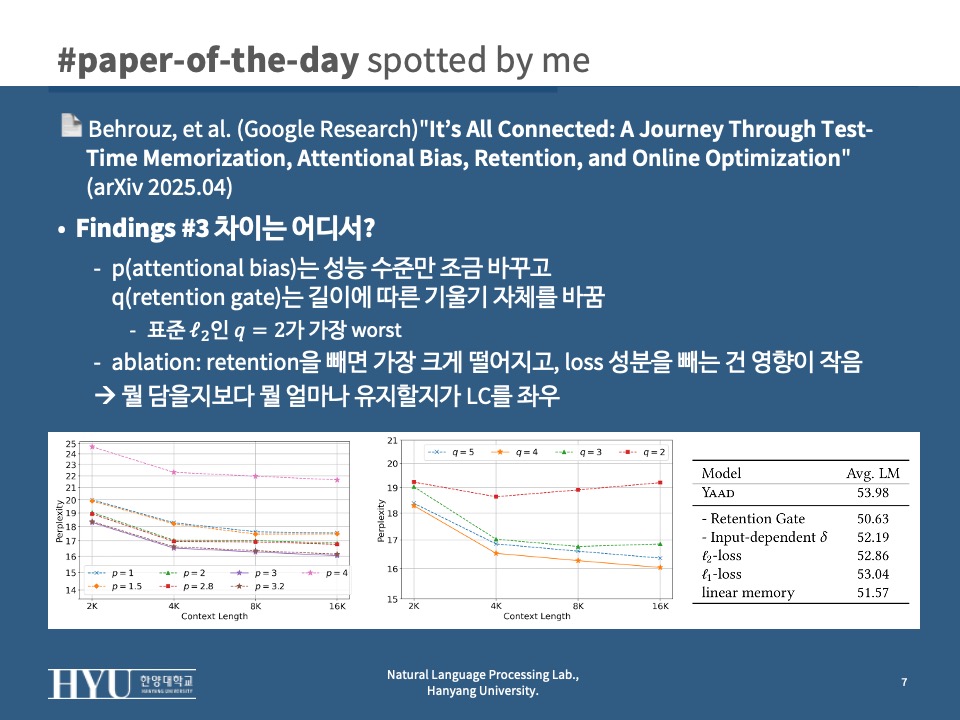
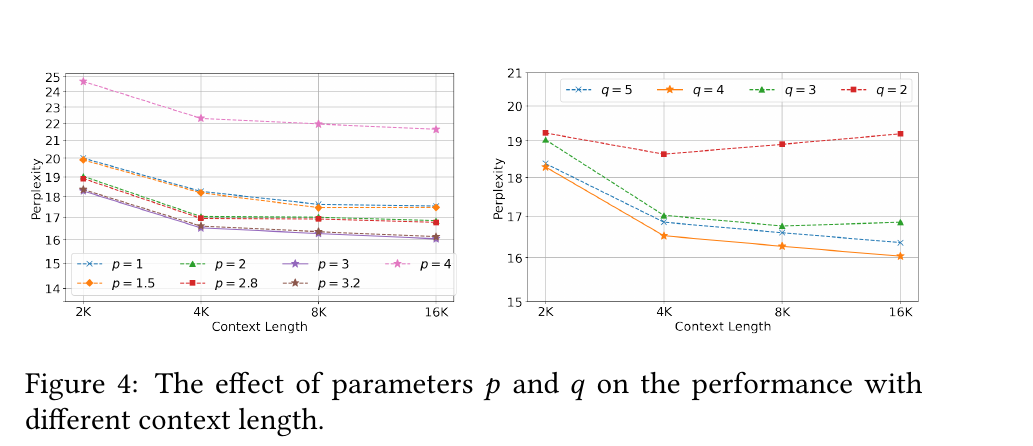
- (원인분석) 차이는 attentional bias보다 retention gate 선택에서 옴
Fig 4- p(attentional bias)는 성능 수준만 조금 바꾸고 길이에 따른 기울기는 그대로, q(retention gate)는 기울기 자체를 바꿈
- 표준 $\ell$2에 해당하는 q = 2가 가장 나쁨 → 기존 모델의 기본 선택이 긴 입력에서는 병목이었다는 해석
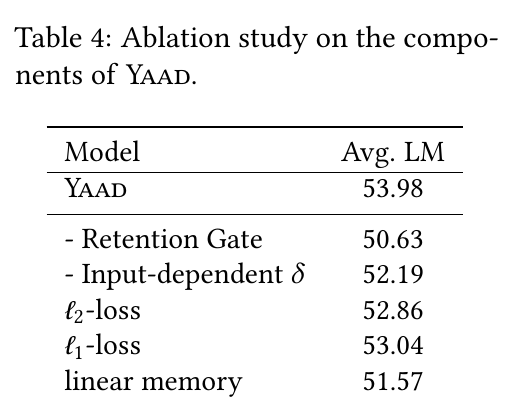
- ablation도 같은 방향
Tab 4- Yaad에서 구성 요소를 하나씩 빼면 모두 성능이 떨어짐
- 가장 크게 떨어지는 건 retention 제거, 다음이 MLP를 행렬로 바꾼 경우 → memory 형태와 retention이 loss 선택보다 중요하다는
Fig 4해석과 일관 - Huber의 두 성분(ℓ2, ℓ1) 중 하나를 빼도 하락 폭은 작음 → attentional bias를 바꾼 효과는 상대적으로 작음
- (본문 외 교차 확인) Titans와의 비교 누락
- Titans 논문 표와 대조하면 340M에서는 사실상 같고
760M LM과 S-NIAH에서는 오히려 Titans가 나음 (두 논문 설정 동일성은 보장xx)- 따라서 세 variant가 같은 그룹의 전작보다 낫다는 근거는 x
framework의 설명력과 variant의 우위는 분리해서 보는 게 맞아보임…
- 따라서 세 variant가 같은 그룹의 전작보다 낫다는 근거는 x
- Titans 논문 표와 대조하면 340M에서는 사실상 같고
- 짧은 입력(4K)에서는 기존 linear RNN과 비슷하거나 조금 나은 수준
Personal note. 동일 저자의 선행연구 Titans가 “뭘 기억할 것인가”를
surprise로 풀었다면, 이 연구에서는 “뭘 얼마나 유지할지”를 retention이라는 이름으로 다시 정리합니다. 여기서 memory는 layer 내부 상태라 agent의 선호 memory와는 다른 지칭이라는 점은 유의해야하는데, 제가 유념할만한 component가 있는지 살펴보려고 봤습니다. 이 논문에서의 memory는 새 정보가 들어올 때 기존 정보를 지우는(DELETE) 대신 얼마나 붙잡을지를 연속적으로 조절한다는 관점(Remark 3)을 주요 킥으로 제안하는데, agent의 memory 설계에도 적용해볼 수 있을지 고민해보려 합니다. (최근 memory 시스템은 KEEP/DELETE 혹은 단순누적 정도로 다루던 방식이므로…)Memora의 KL retention은 결국 직전 분포에 log를 씌우고 gradient를 빼서 다시 정규화하는 꼴이라, belief를 확률이라고 주장하지 않고도 분포를 갱신하는 방법으로 읽힐 여지도 있는 것 같습니다. 다만 Table 1의 통합은 사후적 분류에 가깝고, 정작 Titans (LMM)와의 비교가 빠져 있어서 아쉽습니다.