Beyond the Final Embedding: Retrieving Memories from Token-Level Evidence
- Authors: Han Luo, Zhan Zhuang, Xu He, Jujia Zhao, Yu Li, Suqin Yuan, Dong Li, Lei Feng
- Affiliation: Southeast University, The University of Sydney
- Paper: https://arxiv.org/abs/2610.13277
- Published: October 9, 2026 (arXiv preprint)
TL; DR
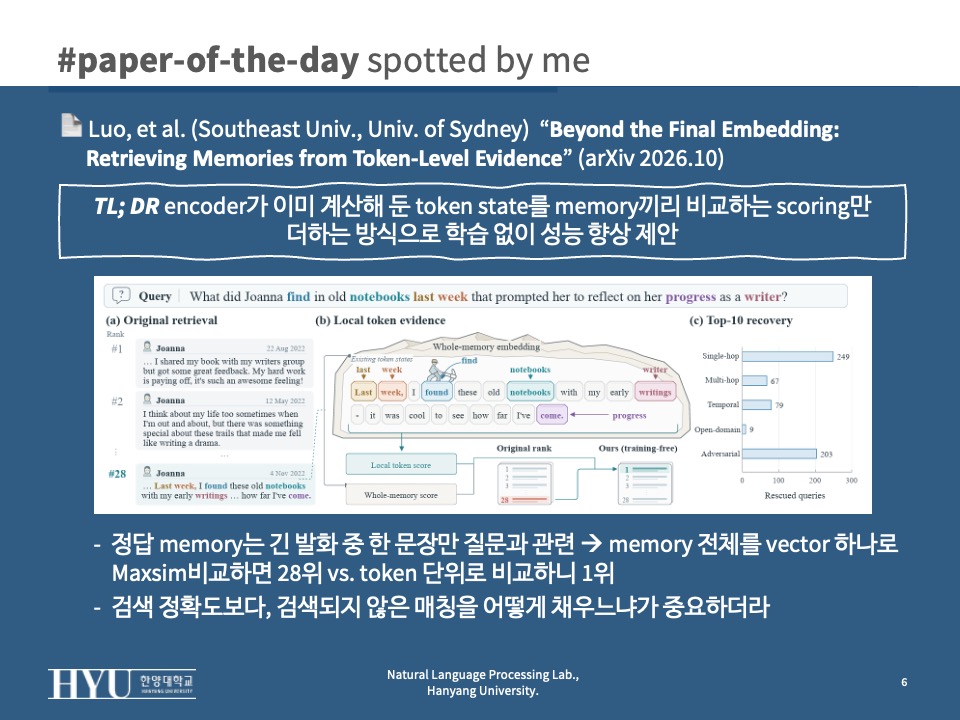
memory retrieval의 손실은 encoder가 아니라 vector 하나로 퉁치는 scoring 단계에서 발생하며, 이미 계산된 token state를 memory끼리 경쟁시키기만 해도 학습 없이 성능 이득 (검색되지 않은 매칭을 어떻게 채우느냐가 관건이다.)
Background
- memory-augmented assistant: 과거 대화와 저장 문서에서 evidence를 꺼내 질의에 답함 (Maharana et al., 2024; Wu et al., 2025)
- 답에 필요한 정보는 memory의 일부에만 있고, query마다 필요한 부분이 다름 (e.g.
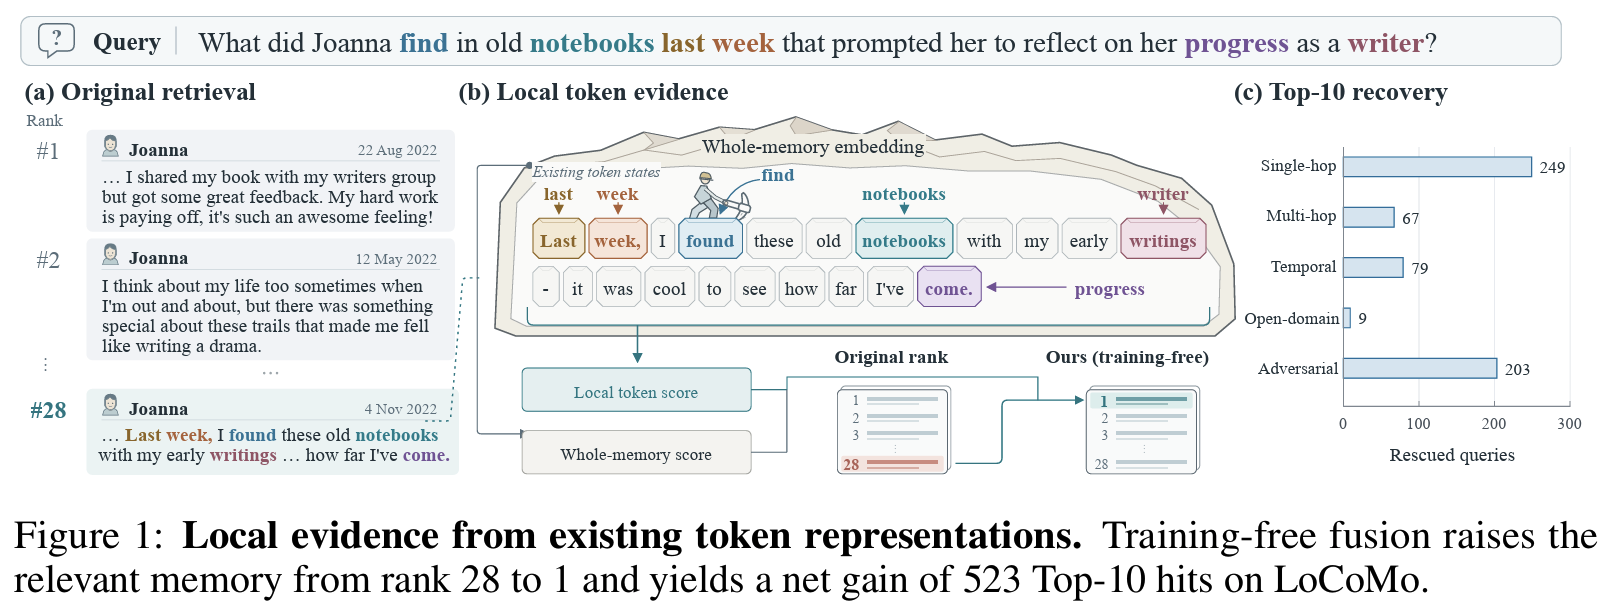
Fig 1)- “지난주 오래된 노트에서 무엇을 발견했나”→긴 발화 안의 한 문장(“Last week, I found these old notebooks …”)만 있으면 됨
- 답에 필요한 정보는 memory의 일부에만 있고, query마다 필요한 부분이 다름 (e.g.
- Single-vector retrieval: query와 memory를 각각 embedding 하나로 압축하고 cosine similarity로 ranking (Karpukhin et al., 2020; Zhang et al., 2025)
- encoder 내부에서는 token마다 contextual state를 계산하지만, 마지막에 pooling해서 vector 하나만 남기고 나머지는 버림
- $s_{\text{pool}}(q, m) = z_q^\top z_m$: memory 전체를 한 점으로 비교하므로, 단위 기준 전체의 일부만 맞는 memory는 순위가 밀릴 수 밖에
- memory당 vector 하나라 index가 작고 검색이 빠르나 표현력의 이론적 한계 보고 (Weller et al., 2026)
- Late interaction 계열: token state를 버리지 않고 query token과 memory token을 직접 비교
-
ColBERT, ColBERTv2 (Khattab & Zaharia, 2020; Santhanam et al., 2022): MaxSim으로 score 계산
\[s_{\text{MaxSim}}(q, m) = \frac{1}{n_q} \sum_i \max_j h_{q,i}^\top h_{m,j}\]- query token마다 memory 안에서 가장 비슷한 token 하나를 찾고, 그 similarity를 query token에 대해 평균
- memory마다 그 안의 모든 token과 비교하므로 비교량과 index 크기가 token 수에 비례
- ColBERT는 이를 위해 encoder를 별도 학습; SMART (Zhang et al., 2026a)는 기존 single-vector encoder의 frozen hidden state에 MaxSim을 붙이고 pooled score와 합침
-
- XTR (Lee et al., 2023): memory별로 전부 비교하지 않고 token부터 검색
- query token마다 모든 memory의 token을 한데 모은 pool에서 top-$k$ token만 검색하고, 검색된 token으로만 memory score를 계산
- 검색되지 않은 token의 similarity는 알 수 없으므로 top-$k$ 중 가장 낮은 값으로 추정 (missing-similarity estimation)
- 본 논문의 sparse matching이 이 방식을 frozen encoder 위로 가져옴
- 그 밖의 방향: final embedding을 개선하거나 그 위에 가벼운 mapping을 얹는 접근
- representation learning: Sentence-BERT (Reimers & Gurevych, 2019), E5 (Wang et al., 2022), 주변 context를 반영하는 InSeNT (Conti et al., 2025), EvoEmbedding (Nie et al., 2026), late chunking (Günther et al., 2024)
- retrieval adaptation: Search-Adaptor (Yoon et al., 2024); index를 다시 만들지 않으려고 query 쪽만 학습하는 query-only adaptation (Jain et al., 2026; Maekawa et al., 2026)
- long-term memory 시스템 (A-Mem, MemoryOS, LightMem, AssoMem 등)은 memory를 어떻게 구조화, 압축, 연결할지에 집중; 고정된 memory bank 안의 scoring 자체는 상대적으로 덜 다뤄짐
Problem States
- encoder는 token 단위 state를 이미 계산하는데, single-vector scoring은 이를 버린다.
- frozen state 위의 late interaction(SMART)도 memory마다 따로 비교할 뿐,
XTR식으로 memory끼리 token 단위로 경쟁시키고 whole-memory score와 합친 시도는 없었다.
- frozen state 위의 late interaction(SMART)도 memory마다 따로 비교할 뿐,
- 같은 encoder 안에 local evidence를 잡을 정보가 있는데 scoring에서 쓰지 않음
- token 단위로 매칭하려면 기존 late interaction은 encoder를 재학습 or memory마다 모든 token 비교해야
- 반면 local 매칭만으로는 memory 전체의 주제 관련성을 놓칠 수도
- supervision으로 더 맞추고 싶어도 encoder나 memory 쪽 표현을 바꾸면 전체 memory 재encoding해야
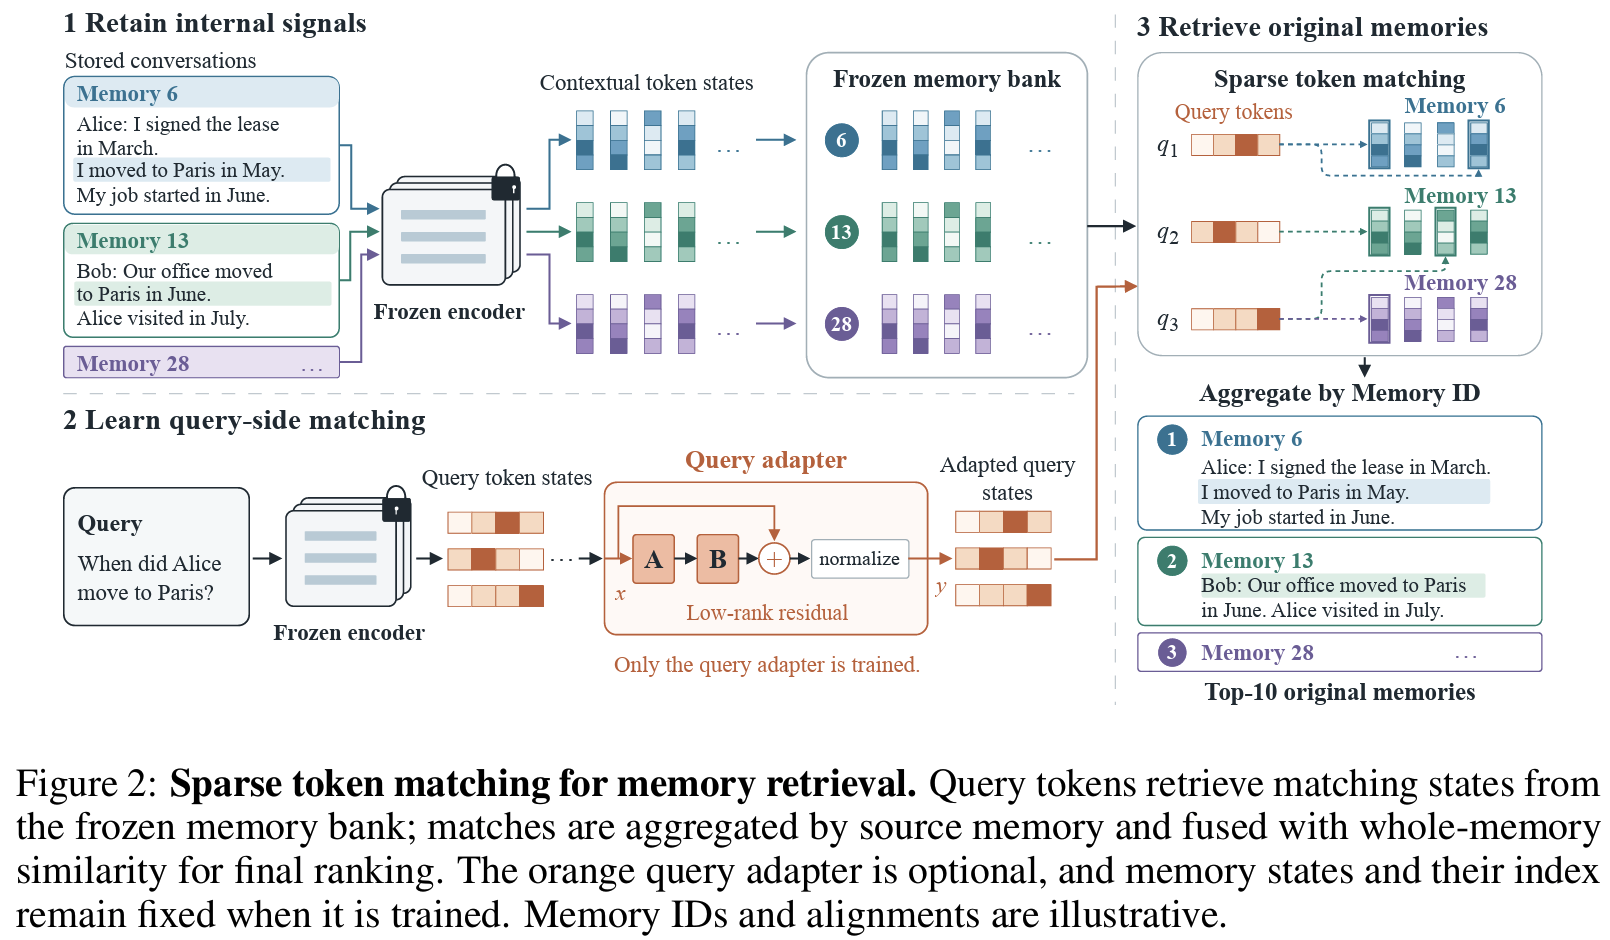
- [저장] 버려지던 token별 벡터를 memory ID와 함께 남긴다
- [매칭] query token마다 전체 memory에서 비슷한 token을 찾아, 그 token이 속한 memory에 score를 준다
- [결합] 이 token score를 기존 vector score와 섞어 최종 순위를 매긴다
- [적응] (선택) memory는 그대로 두고 query 쪽 token 벡터만 학습해 매칭을 다듬는다
Suggestions
Fig 2: “When did Alice move to Paris?”- memory 6 (Alice): “I signed the lease in March. I moved to Paris in May. My job started in June.” →
정답 - memory 13 (Bob): “Our office moved to Paris in June. Alice visited in July.”
- memory 전체를 vector 하나로 보면 둘 다 Alice, Paris, 이사, 월이 섞인 이야기라 구분이 어려움
- token 단위로 보면 query의 “move”가 memory 6의 “moved to Paris in May”와 직접 맞음 → 이 신호를 score로 쓰자
- memory 6 (Alice): “I signed the lease in March. I moved to Paris in May. My job started in June.” →
- memory 전체를 vector 하나로 비교하는 기존 scoring 방식에 “query의 token이 그 memory 안의 token과 직접 맞는가”를 더하는 방식
- 새로 학습 없이: token별 벡터는 embedding 모델이 vector 하나를 만들기 직전에 이미 계산해 둔 것을 활용하며
-
최종 score는 두 score의 가중 평균 (아래 단계는 결국 이 식의 둘째 항 $s_{\text{sparse}}$을 어떻게 계산하는지)
\[s_{\text{fused}}(q, m) = \alpha\ \hat s_{\text{pool}}(q, m) + (1 - \alpha)\ \hat s_{\text{sparse}}(q, m)\]- $s_{\text{pool}}$: 기존 scoring (query vector와 memory vector 하나끼리 비교)
- $s_{\text{sparse}}$: 새로 더하는 scoring (query token과 memory token끼리 비교)
[저장] token 벡터를 memory ID와 함께 저장
- memory를 embedding 모델(frozen encoder)에 한 번 넣을 때, 예의 1개의 vector 외에 token별 벡터도 함께 저장
- $z_m$: 평소 쓰던 memory vector (pooling 결과)
- $H_m = [h_{m,1}, \dots, h_{m,n_m}]$: 마지막 layer의 token별 벡터 (padding, special token 제외)
- (query도 똑같이 $z_q$와 $H_q$를 구하도록)
- token 벡터마다 출처 memory ID 부여 : 다음 단계에서 token 단위로 검색시 최종적 순위의 대상은 token이 아니라 memory이기에
- e.g. 검색된 “moved” 벡터에 “memory 6”이라는 단서가 있어야 memory 6에 가점 가능
- memory는 query와 무관하게 1 회만 저장하면 되므로, 대가는 저장량이 token 수만큼 늘어난다는 것 정도
[매칭] query token마다 전체 memory에서 비슷한 token 찾기 (Global Sparse Token Matching)
- query token 하나씩, 모든 후보 memory의 token을 한데 모은 pool에서 가장 비슷한 token $k = 64$개를 찾음 (이 집합이 $R_i$)
- 걸린 token의 memory ID를 보고, 그 memory에 similarity만큼 score를 줌; 한 memory에서 여러 token이 걸리면 가장 높은 것 하나만 씀
- e.g. query token “move”로 검색하면 memory 6의 “moved”, memory 13의 “moved” 등이 함께 걸림
- k개 안에 token이 하나도 안 걸린 memory?
- 0으로 두면 “아깝게 65등 한 memory”와 “전혀 관련 없는 memory”가 같아지는 문제
- 그래서 64등의 similarity $t_i$를 바닥값(floor)로 filling: k 안에 들지 못한 memory는 최소한 k등보다는 덜 비슷할 것이므로 (XTR의 missing-similarity estimation)
- $t_i = \big[\min_{h \in R_i} h_{q,i}^\top h\big]_+$ (음수면 0)
- memory score = query token마다 “그 memory가 받은 score와 floor 중 큰 값”을 구해 평균
- floor는 모든 memory에 똑같이 부여되므로, memory 사이의 순위를 가르는 건 floor를 넘어선 score들 뿐
- 왜 memory마다 MaxSim(하나씩 비교)하지 않고 전체에서 찾나
- MaxSim: memory마다 “그 안에서 query token과 가장 비슷한 token”을 고름 → memory 내부 경쟁
- 이 방법: query token 하나가 전체 memory를 상대로 k개만 고름 → memory 간 경쟁
- (추측) token이 흔할수록 floor가 높아져 영향력이 사라짐 → IDF와 비슷한 효과
- 흔한 token(“Alice”): k개 전부가 여러 memory의 “Alice”(similarity 약 0.9)로 채워져 floor도 약 0.89 → Alice가 없는 memory까지 0.89를 받아, 이 token은 memory 간 차이를 거의 만들지 못함
- 드문 token(“notebooks”): 실제로 나오는 memory는 한두 개뿐이라 나머지 자리는 애매하게 비슷한 token으로 채워짐 → floor가 약 0.4로 낮아, 해당 memory만 0.9로 크게 앞서감
- MaxSim은 memory마다 따로 최댓값을 구하므로 “Alice”가 있는 memory(0.9)와 없는 memory(0.3)의 차이가 계속 남음; 한 사람의 대화처럼 Alice가 거의 모든 memory에 나오면 이 차이는 정답과 무관한 noise
- 단, token이 k개보다 많은 memory에 나올 때만 성립 (LoCoMo는 query당 후보 memory 약 570개, k = 64)
- 실제로 MaxSim으로 바꾸면 성능이 떨어짐 (Effects의 원인분석)
[결합] Local–Global Fusion
- token score와 기존 vector score fusion
- token-only: token 몇 개만 우연히 겹친 엉뚱한 memory가 올라올 여지
- vector-only: 일부만 query와 맞는 memory(memory 6 같은)가 밀릴 여지
- 두 score는 범위가 달라 그대로 더할 수는 없으므로 query마다 후보 memory들 안에서 평균 0, 표준편차 1로 정규화($\hat s$), $s_{\text{fused}}$ 계산, $\alpha = 0.5$
[적응] (Optional) query 쪽 token 벡터만 학습 (Query Adaptation)
- 정답 memory 라벨이 있을 때 매칭 학습: query token 벡터에만 작용, query vector $z_q$와 저장된 memory는 고정
-
저장된 memory는 건드리지 않되, (memory 재encoding 필요x) query 쪽 token 벡터에만 보정 (LoRA-st low-rank residual)
\[T_\theta(h) = \frac{\lVert h \rVert_2 (h + BAh)}{\max(\lVert h + BAh \rVert_2, \epsilon)}, \qquad \tilde h_{q,i} = T_\theta(h_{q,i})\]- $A \in \mathbb{R}^{r \times d}$, $B \in \mathbb{R}^{d \times r}$: 모든 query 위치에서 공유하는 bias 없는 행렬, rank $r = 32$, parameter는 $2dr$개 (0.6B 기준 약 65K)
- 분자와 분모의 norm 비율: 변환 후에도 입력 norm을 그대로 유지 → similarity를 키우려고 벡터 크기만 부풀리는 꼼수를 막음
- $B$를 0으로 초기화하므로 학습 시작 시점에는 원래 query와 동일
-
- objective: top-$k$ 검색은 이산적 선택이라 미분 불가, 학습 때는 MaxSim을 미분 가능한 대리 score로 사용
- $s^\theta_{\text{MaxSim}}$: MaxSim의 $h_{q,i}$를 $\tilde h_{q,i}$로 바꾼 score
- 정답 memory가 여러 개일 수 있는 contrastive loss: $\mathcal{L} = -\log \frac{\sum_{m \in G_q} \exp(s^\theta_{\text{MaxSim}}(q,m)/\tau)}{\sum_{m \in C_q} \exp(s^\theta_{\text{MaxSim}}(q,m)/\tau)}$
- $C_q$: 학습 후보 집합, $G_q$: 정답 memory 집합, $\tau = 0.07$
- inference 때는 보정된 query token으로 2단계 매칭을 하고, 3단계에서 그대로 섞음
- 효과는 미미: 학습 없는 버전 위에 소폭 더하는 수준, backbone에 따라 효과가 없기도 (하기 참고)
Effects
- Experimental setup
- benchmark: LMEB (Zhao et al., 2026), 8개 benchmark 5,873 query
- conversational memory: LoCoMo, LongMemEval, REALTALK (Lee et al., 2025)
- document: ESG-Reports (재무 보고서), QASPER, PeerQA (논문), CovidQA (의생명), MLDR (장문서)
- metric: 상위 10개 안에 정답이 든 비율(Recall@10)과 순위까지 반영한 NDCG@10, benchmark별 동일 가중 평균
- baselines
- 같은 backbone: Original embedding, Search-Adaptor, Chunk-MaxP (512-token chunk별 embedding 중 최댓값), MaxSim (frozen token에 ColBERT식 비교), BM25 + Original (같은 정규화로 동일 가중 결합)
- 독립 시스템: BM25, ColBERTv2, XTR, ConstBERT
- 각자 고유 encoder를 쓰므로 같은 backbone끼리의 비교는 아님
- backbone 8종 (모두 frozen): Qwen3-Embedding 0.6B/4B/8B, NVIDIA Llama 계열 1B/3B/8B, EmbeddingGemma-300M, Jina-Embeddings-v5-text-nano
- 구현: token budget $k = 64$, $\alpha = 0.5$, token state는 FP16 저장
- query adapter와 Search-Adaptor는 EvoTrain-180K에서 뽑은 1,024개로만 학습 (평가 benchmark 데이터 미사용), 3 seed 평균
- downstream QA: 답변 모델 Qwen3-30B-A3B-Instruct, judge GPT-4o-mini, memory 10개 retrieval
- LoCoMo 1,540문항, LongMemEval 500문항, accuracy와 F1
- Original과 query adapter 버전 둘만 비교 (training-free 버전이나 ColBERTv2 등은 QA에서 비교하지 않음)
- benchmark: LMEB (Zhao et al., 2026), 8개 benchmark 5,873 query
- Results
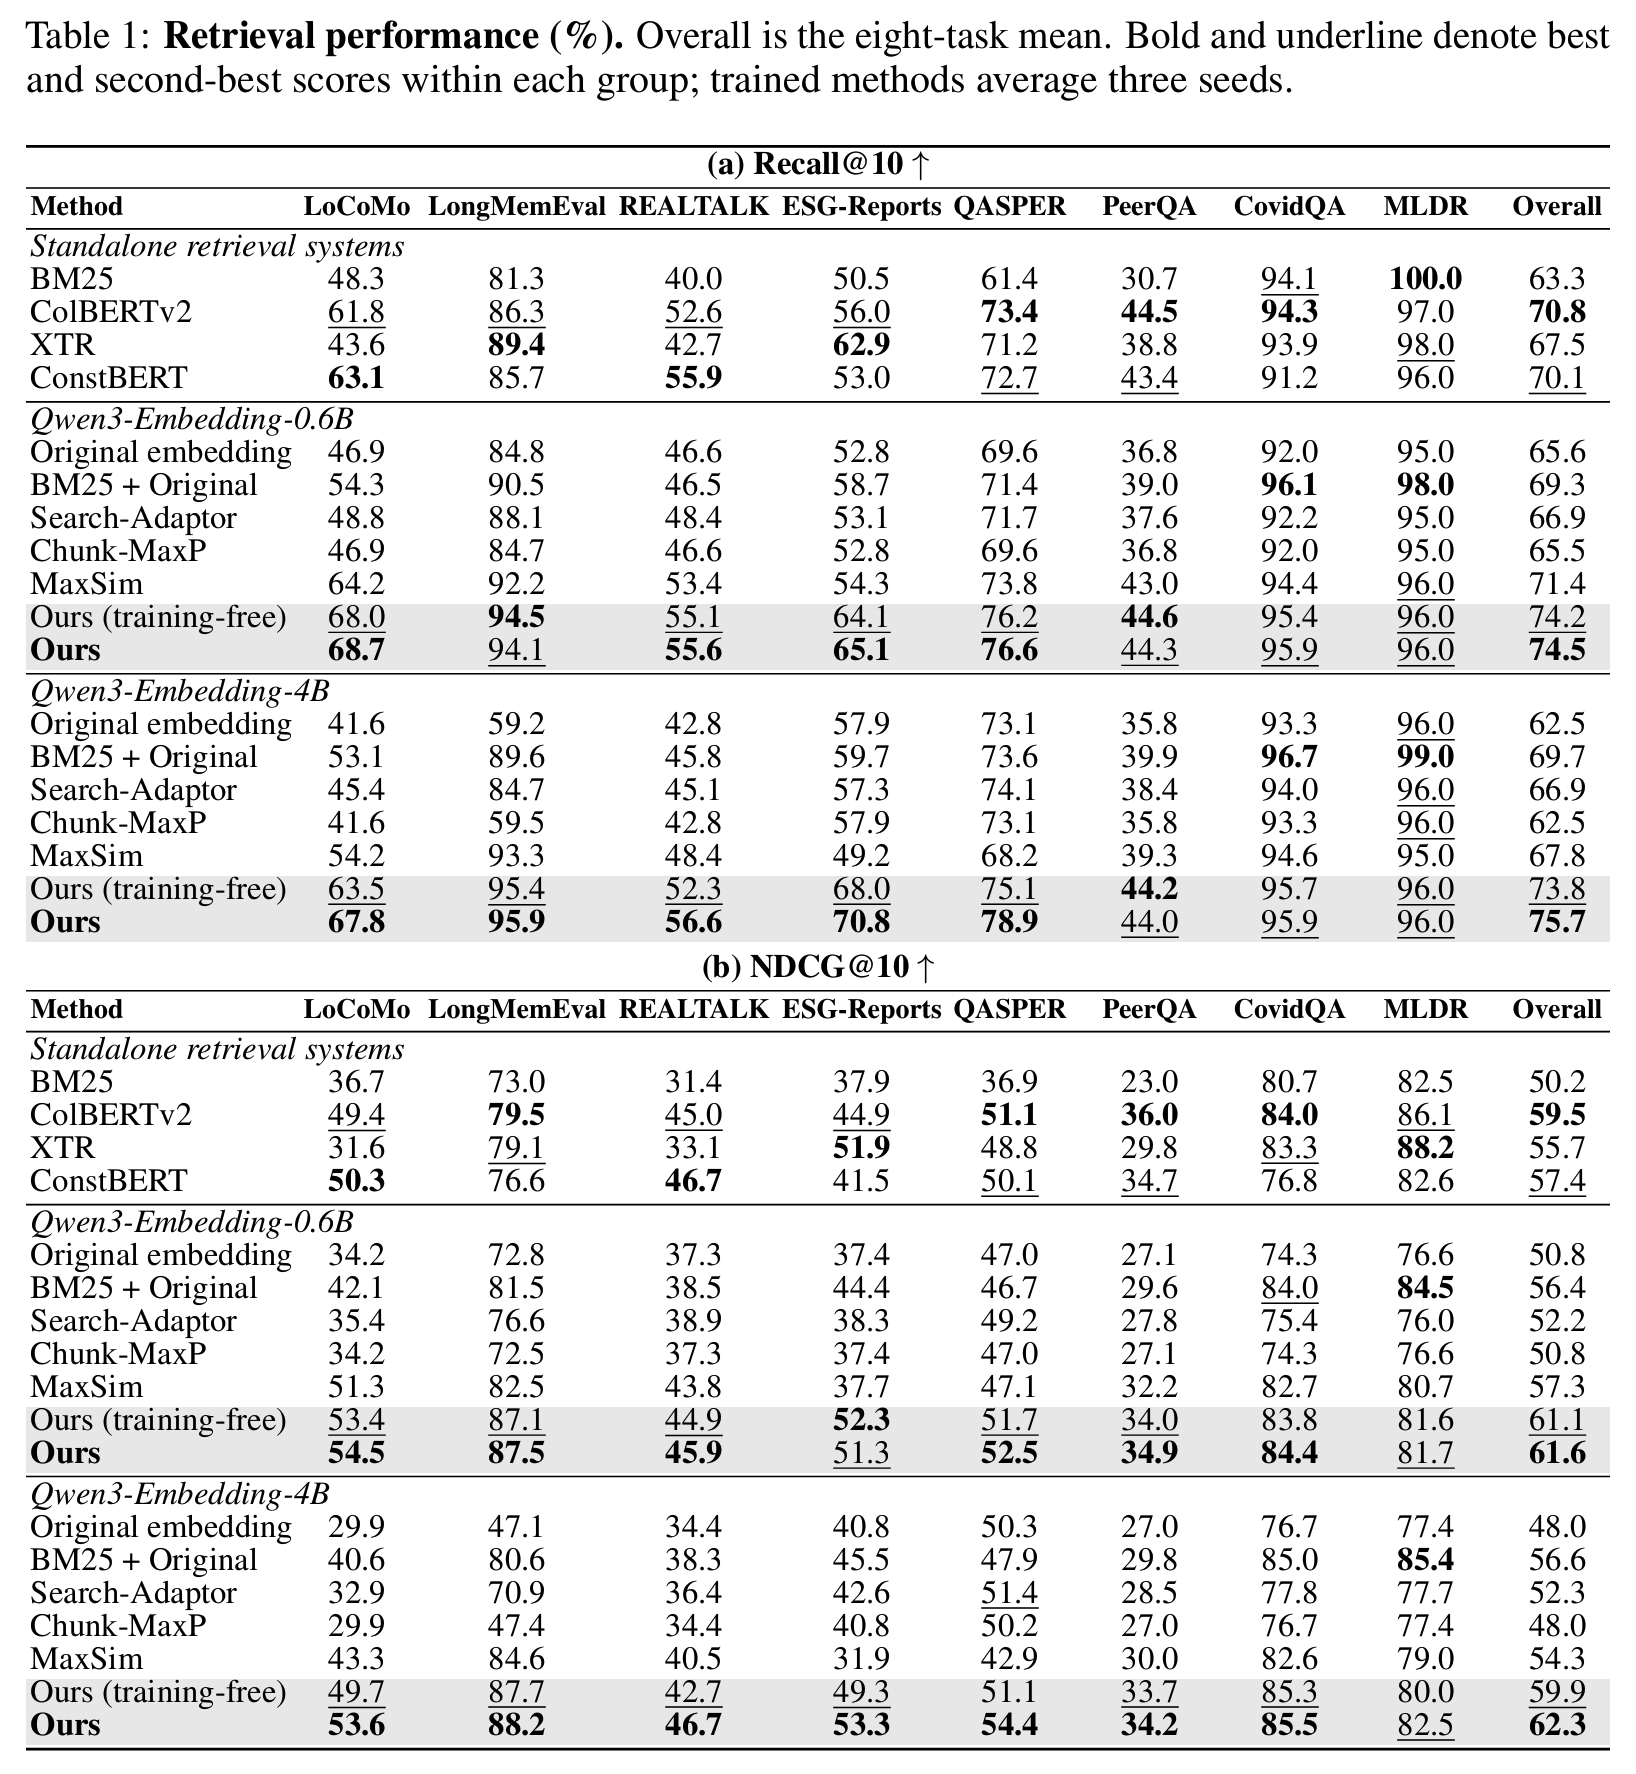
- 학습 없이도 gain, 대화형 memory에서 특히 압도적
Tab 1- 이득의 출처는 학습이 아니라 이미 있던 token state: training-free만으로 Original 대비 크게 향상
- query adapter는 그 위에 소폭 더하는 수준
- 같은 backbone에 MaxSim을 붙인 경우 혹은 별도 학습한 ColBERTv2보다도 높은 평균 달성
- 대화형 memory: LoCoMo, LongMemEval 등에서 큰 gain
- 한 memory가 여러 발화를 담고 query는 그중 한 문장만 묻는 구조라 pooling 손실이 가장 큰 곳이므로
- 문서형 memory: benchmark별로 상이. PeerQA는 ColBERTv2, 장문서(MLDR)는 BM25가 오히려 우세
Fig 1) 정답 memory가 28위 → 1위, LoCoMo 에서 Top-10에 정답이 새로 들어온 query가 빠진 query보다 훨씬 많음- 단 open-domain 유형은 빠진 쪽이 더 많기도
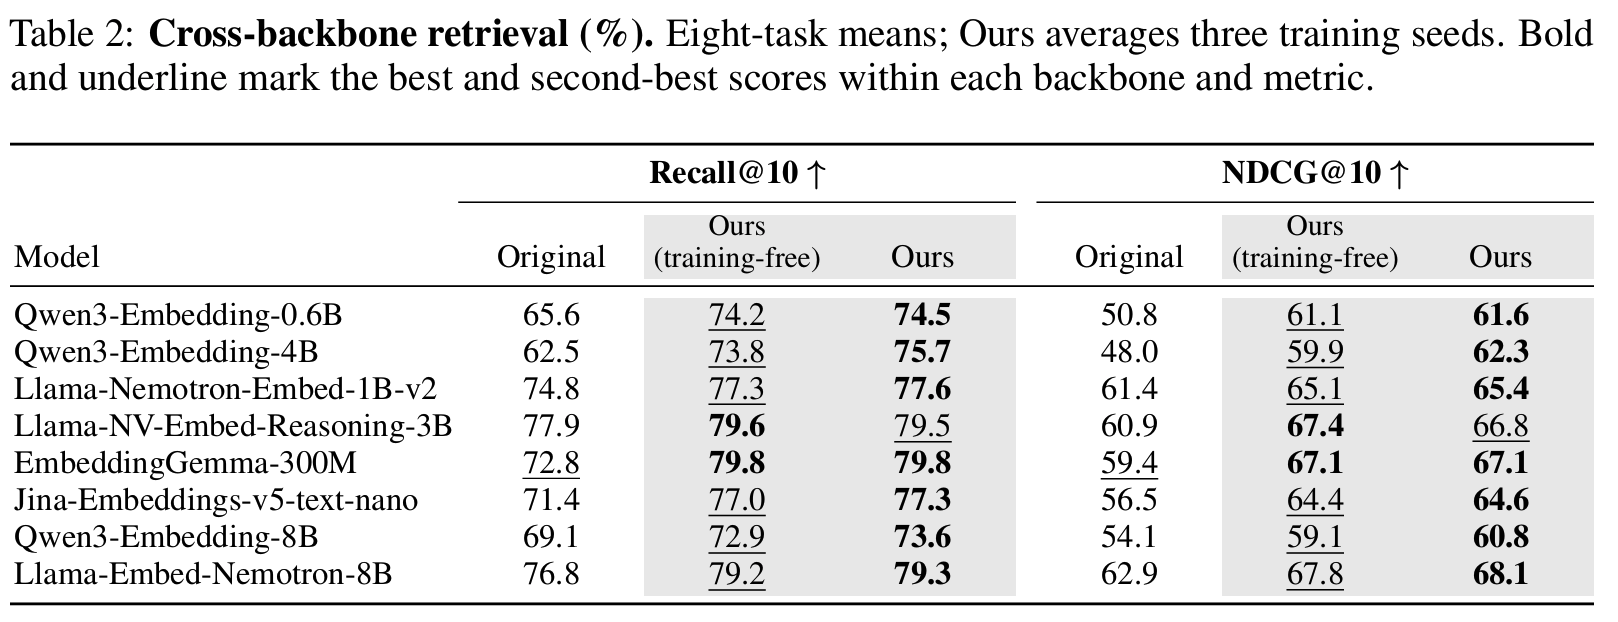
- 이득의 출처는 학습이 아니라 이미 있던 token state: training-free만으로 Original 대비 크게 향상
- backbone이 강할수록 gain이 줄어듦
Tab 2- 8개 backbone 모두 개선, Original이 이미 강한 Llama 계열에서는 이득이 작고 Original이 약한 Qwen3-4B에서 가장 큼
- query adapter 효과도 backbone에 따라 다름: 일부는 변화가 없거나 소폭 하락 → 따라서 말 그대로 optional
- retrieval 개선이 QA 정확도로 이어지나, preference 에서는 불안정
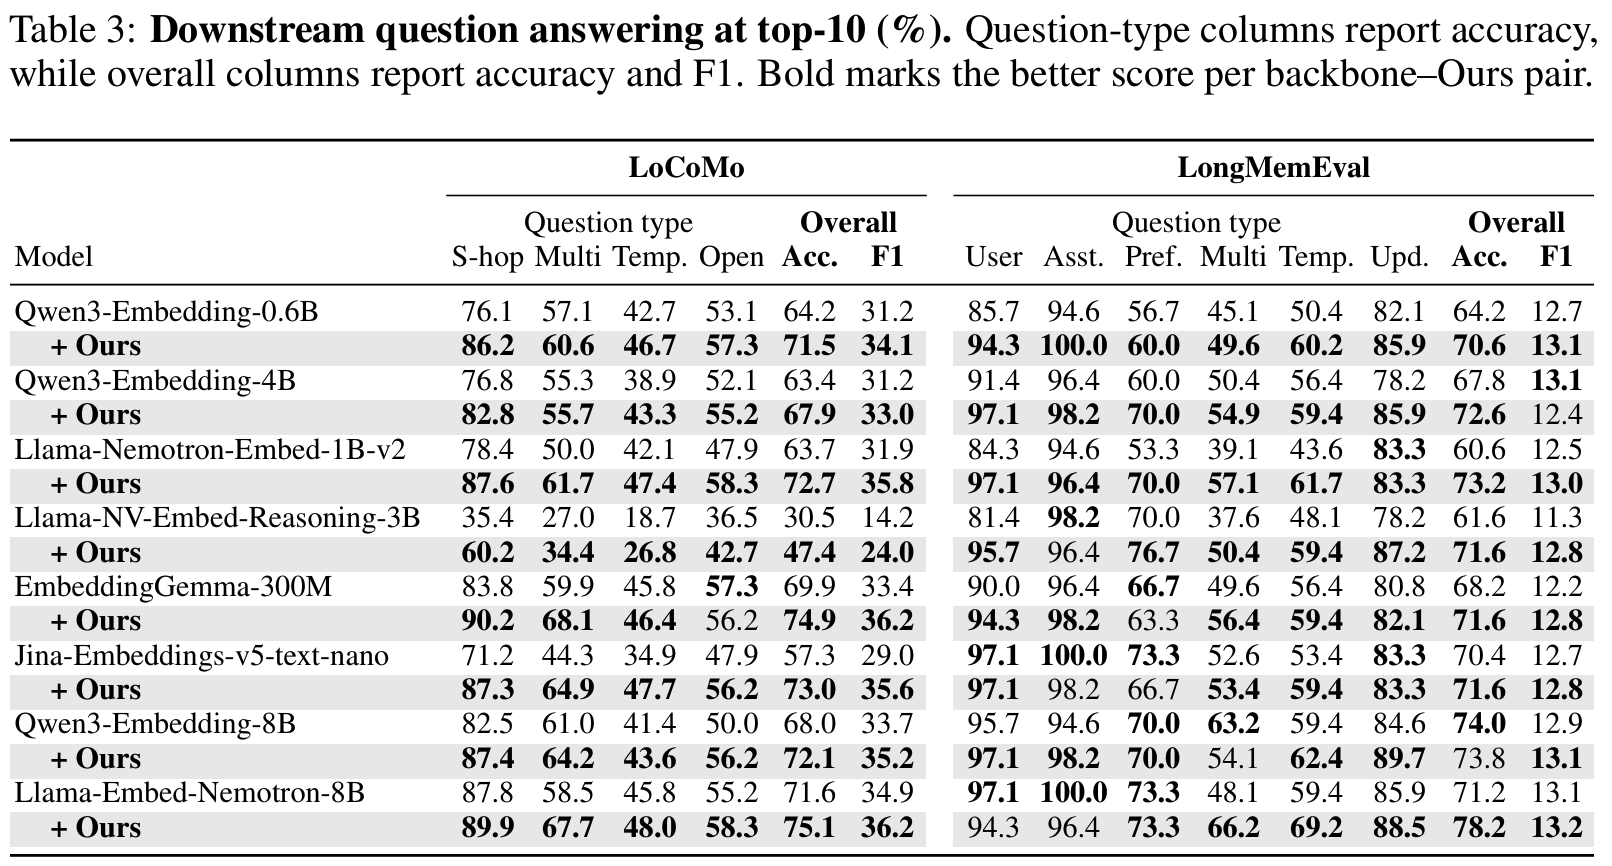
Tab 3- LoCoMo) 8개 backbone 모두, LongMemEval) 8개 중 7개 성능 향상
- 질문 유형별로 보면 single-hop과 knowledge update 질문에서 gain 뚜렷
- 반면 preference 유형은 backbone에 따라 상이
- LoCoMo) 8개 backbone 모두, LongMemEval) 8개 중 7개 성능 향상
- (원인분석) 이득은 memory 간 경쟁 및 k개에 안 든 경우의 처리에서 발생
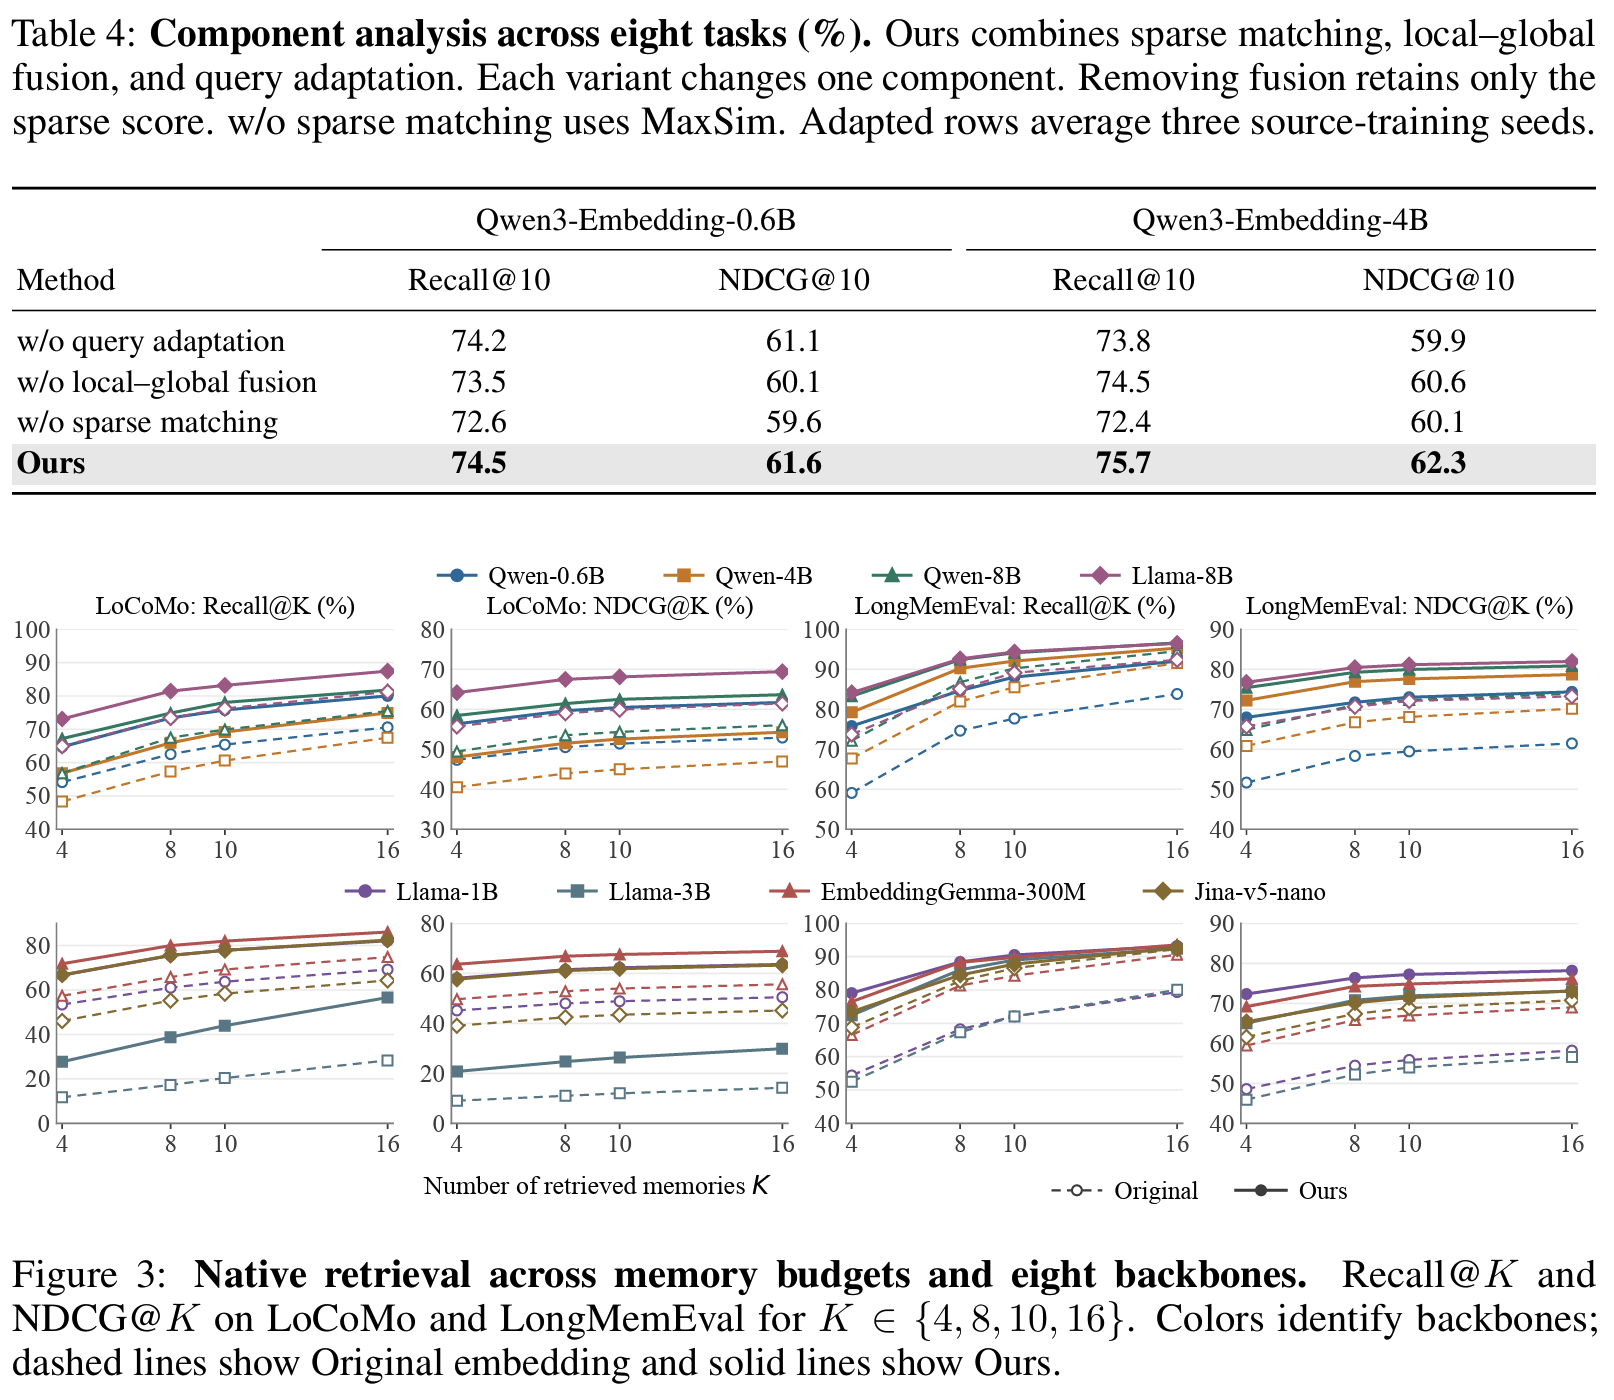
Tab 4,Tab 10, App D- chunk를 32 token까지 잘게 나눠 따로 embedding해도 Original과 동일
- 비교 단위를 작게 만드는 것만으로는 이득 xx
- sparse matching을 memory별 MaxSim으로 교체시 성능 하락
- 더 많이 비교하는 것보다 memory끼리 경쟁시키는 편이 낫다
- floor를 0으로 바꾸면 크게 하락하는데, 근사 검색을 정확한 검색으로 바꿔도 거의 변화 없음
- 검색 정확도보다 검색되지 않은 매칭을 어떻게 채우느냐가 더 중요한 요인
- whole-memory score를 빼도 하락
- local과 global score가 서로 보완
- chunk를 32 token까지 잘게 나눠 따로 embedding해도 Original과 동일
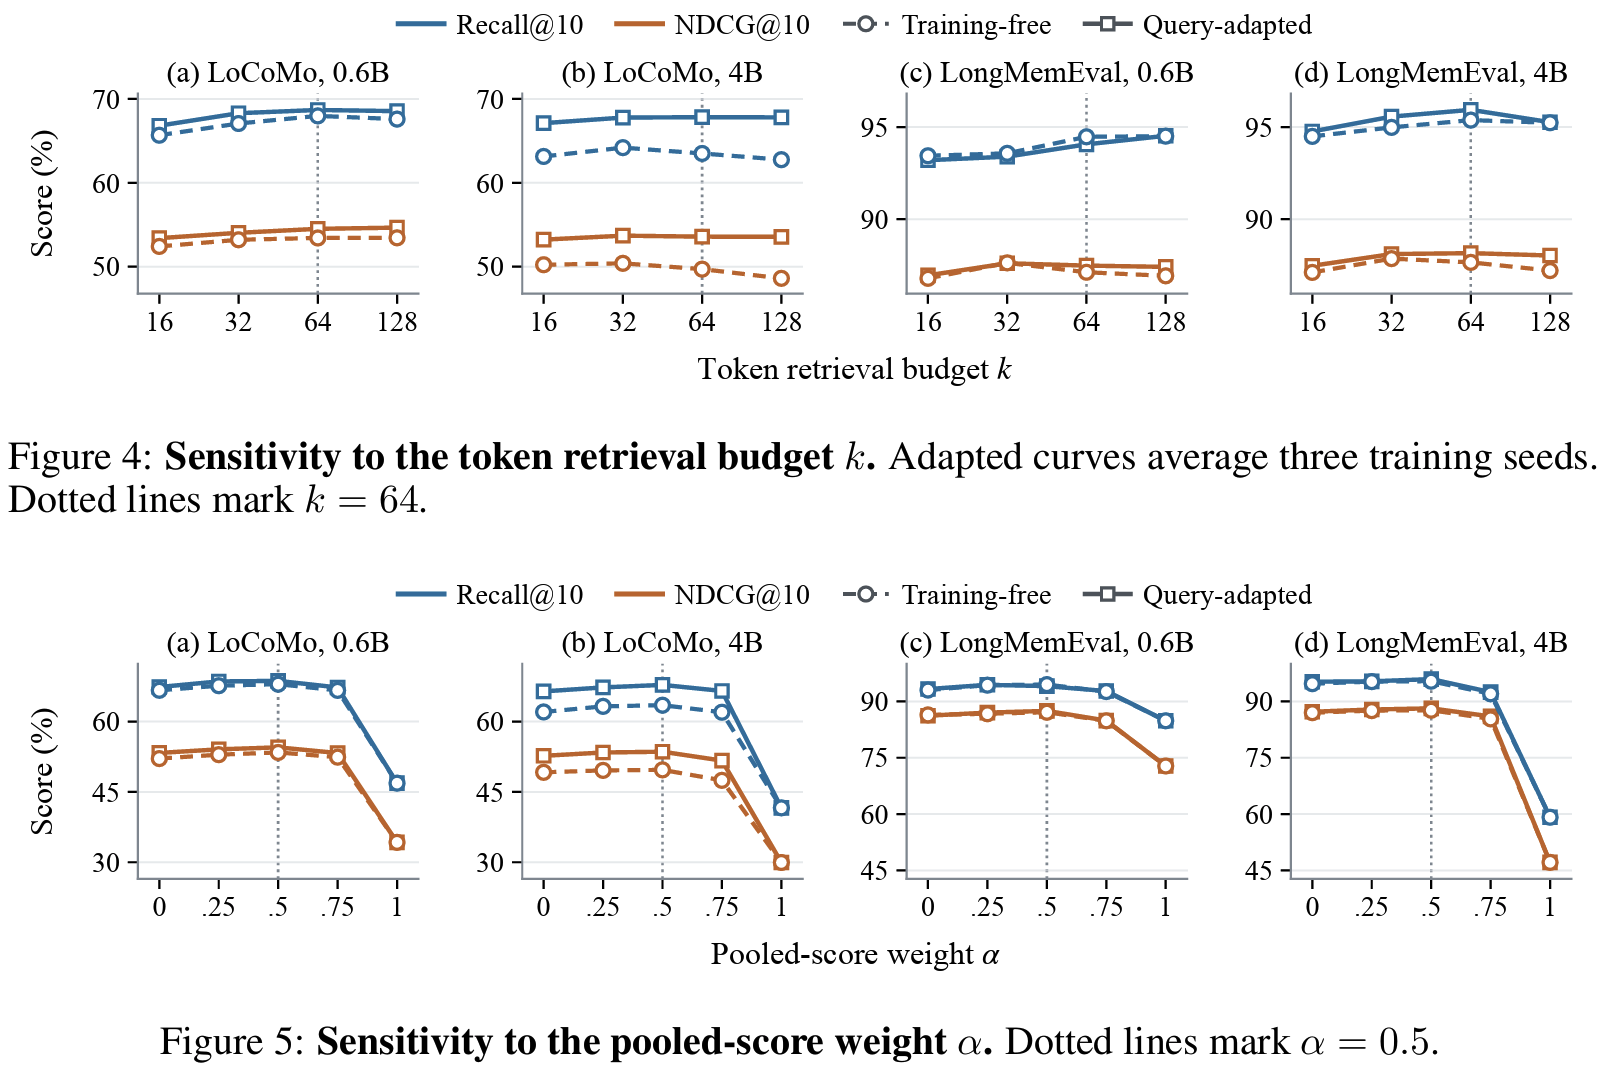
- (sensitivity) hyperparam. 에 강건
Fig 3, 4, 5- 넘겨주는 memory 수 $K$, query token당 검색 개수 $k$, vector score 비중 $\alpha$를 바꿔도 Original보다 우세
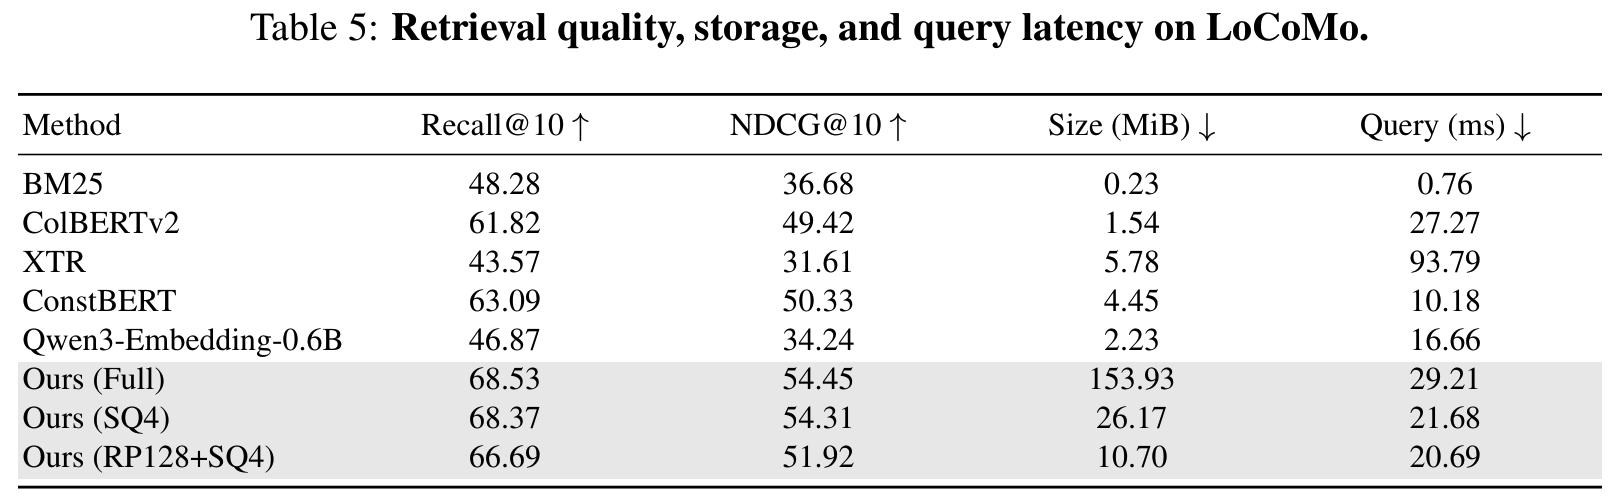
- (efficiency) 저장량은 Original의 약 70배지만, 4-bit로 줄이면 10배 남짓에 성능 유지
Tab 5- 검색 시간 증가는 약 5 ms 수준
- 🤔
- Qwen3-4B 기준을 대표로 언급하면서 내세운 Recall@10 +13.3pp, Original 성능이 너무너무 낮음.. (0.6B보다도 낮음, 특히 LongMemEval 59.2 vs 84.8)
- → 유독 취약했던 baseline의 gain이라 상대적으로 큰 backbone에서의 gain은 +1.6~+4.5pp 수준
- BM25 score와 섞기만 해도 4B 기준 이득의 절반 이상(55~60%)이 회복되나, 본문에서는 딱히 강조 없음
- sparse matching이 MaxSim보다 나은 이유 설명되지 않음
- LongMemEval F1은 모든 조건에서 12~13 근처로 거의 같아 정보가 없고,
preference 유형은 30문항이라 1문항이 3.3pp- → 사실 등락을 해석하기 어렵다고 보고 유의성 검정도 없음
- Qwen3-4B 기준을 대표로 언급하면서 내세운 Recall@10 +13.3pp, Original 성능이 너무너무 낮음.. (0.6B보다도 낮음, 특히 LongMemEval 59.2 vs 84.8)
- 학습 없이도 gain, 대화형 memory에서 특히 압도적
Personal note. memory도 잘써보자는 측면의 retrieval 논문이긴 한데, memory를 vector 하나로 접어서 비교하는 순간 정작 필요한 local evidence가 scoring에서 사라진다는 문제 의식이 좀 고전적인 것 같기는 해도, 그 고전 방식을 최신식으로 하면 PRefine 식의 abstraction인가 싶기도 하더라고요. 해석을 저장 시점이 아니라 꺼내는 시점으로 미룬다고 볼 수도 있을 것 같고, raw context를 직접 읽을 수 있다면 굳이 추상화해야 하는가?라는 질문에 retrieval 측면으로 봐도 역시 그렇다는 결론이 나지 않나 싶습니다.
논문에서는 대화형 memory에서의 이득이 크다고 보고하고는 있는데, 이 방법은 query와 memory가 token 수준에서 겹친다는 가정 위에 있으므로 요청과 겹치는 단어가 거의 없는 personalized한 상황에서 쓰기는 어렵지 않나 싶습니다. preference 유형 QA에서 이득이 들쭉날쭉한 것도 같은 근거로 해석할 수 있지 않나 싶고요.